GMKtec M7 Pro実機レビュー|Radeon 680MのローカルLLMは毎秒20トークン超、24時間の電気代と温度【2026年10月】
本記事にはアフィリエイト広告(Amazon・楽天市場等)のリンクが含まれています。
Radeon 680MでもMoEモデルなら毎秒20トークン超。24時間動かして平均10W
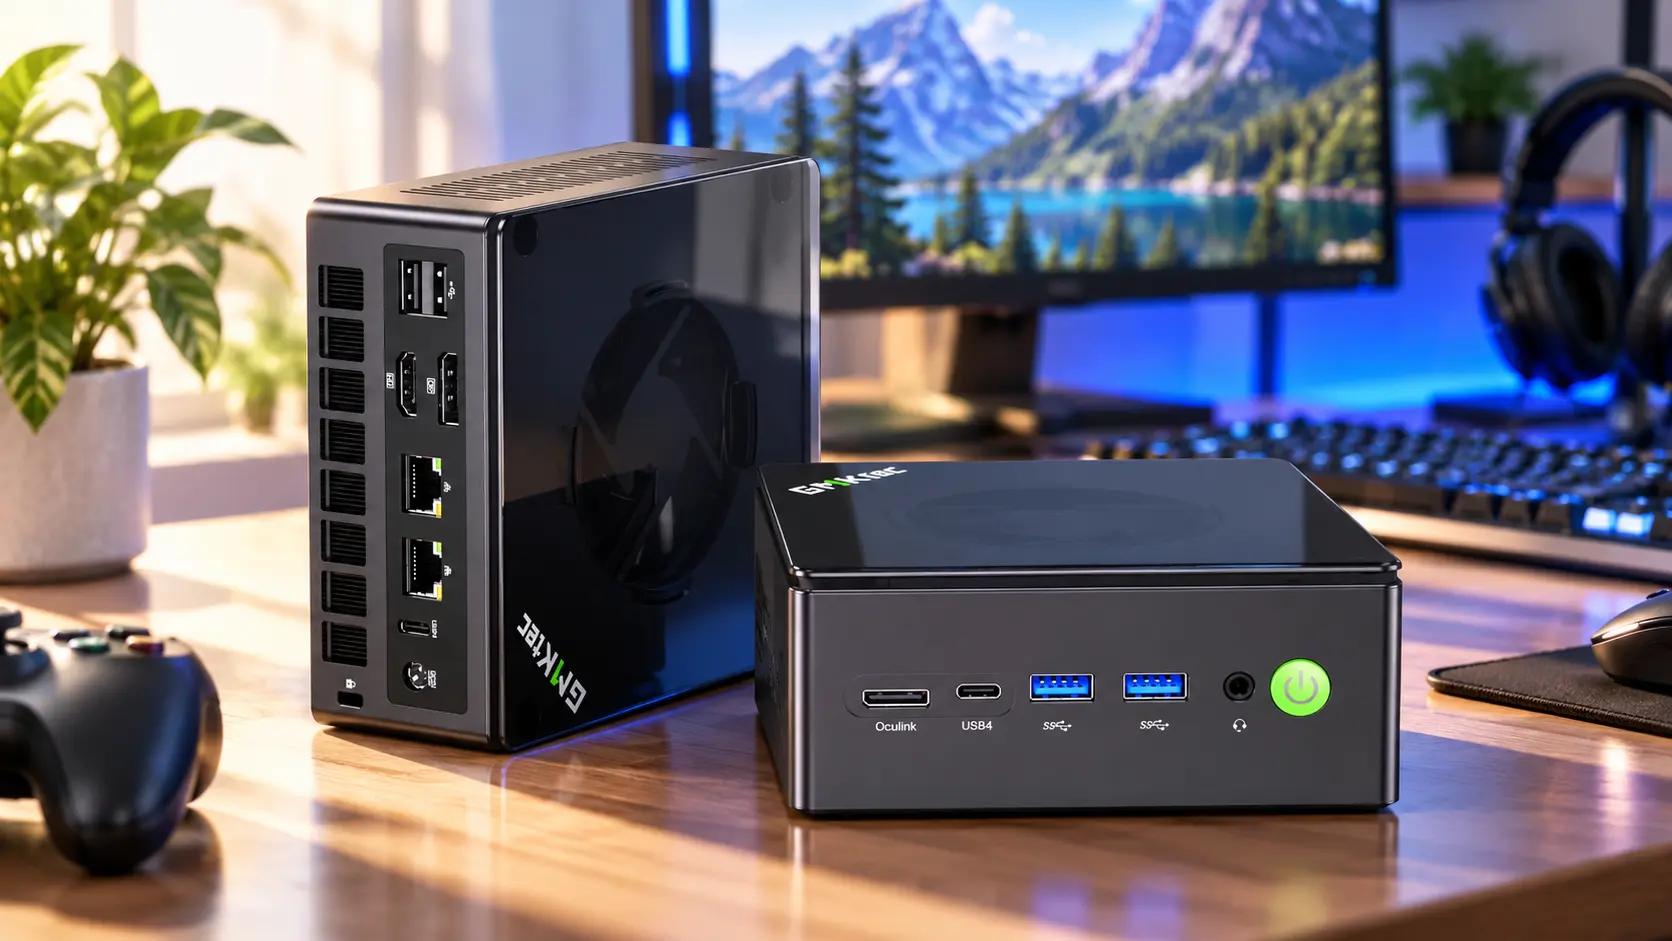
自宅で24時間動かすサーバーや、手元でローカルLLM(大規模言語モデル)を動かす機械として、内蔵GPUのミニPCで足りるのか。GMKtecの「NucBox M7 Pro」は、AMDのRyzen 9 PRO 6950Hと内蔵GPUのRadeon 680Mを、132×125×58mmの筐体に収めたミニPCです。2026年9月に32GB+1TBの構成を約9万6,000円で購入し、AIエージェント(Claude Code)の自動処理を一日中回すサーバーとして使ってきました。
ローカルLLMは、20〜30B級のMoEモデルなら毎秒20〜23トークンで動きました。8Bの通常のモデルは毎秒13.4トークン、14Bは毎秒7.2トークンです。24時間動かしたときの電力は、CPUと内蔵GPUを合わせたチップ全体で平均10.1Wでした。電気代に直すと月に約330〜580円です。処理が集中する時間帯は32W・93℃まで上がりますが、30Wを超えていたのは全体の2%の時間だけでした。
注意点は2つあります。1つは、M7 Proは10月8日時点でAmazon.co.jpとGMKtec JP公式ストアに出品がなく、新品を国内で手に入れにくいことです。同じRadeon 680Mを積む兄弟機のM7とM7 Ultraなら今も買えます。もう1つは、LLMの生成速度はほぼメモリの速さで決まることです。もっと速くしたいならDDR5-5600で動くRadeon 780M機、70B級まで動かしたいならRyzen AI Max+機を選ぶことになります。
目次
スペックM7 ProはRyzen 9 PRO 6950HとDDR5メモリ2枚の構成
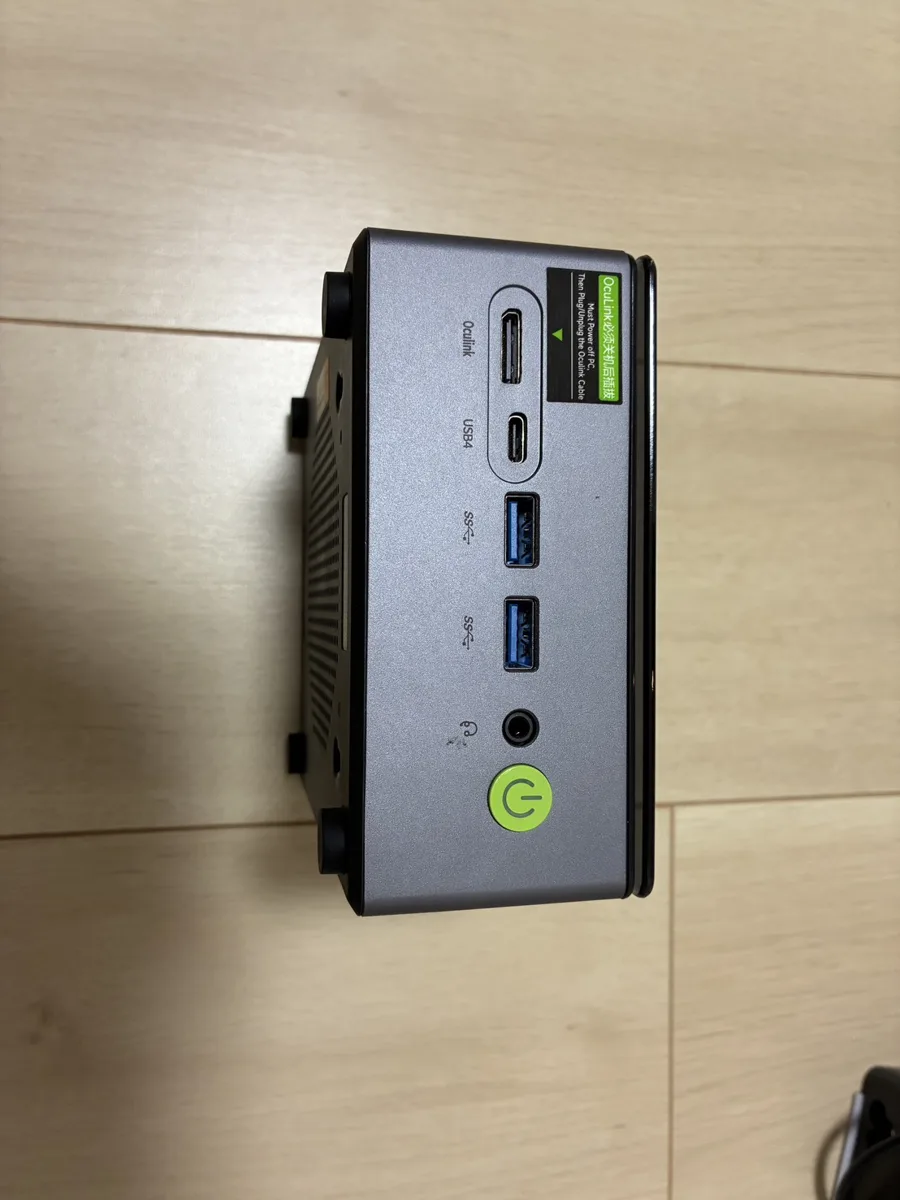
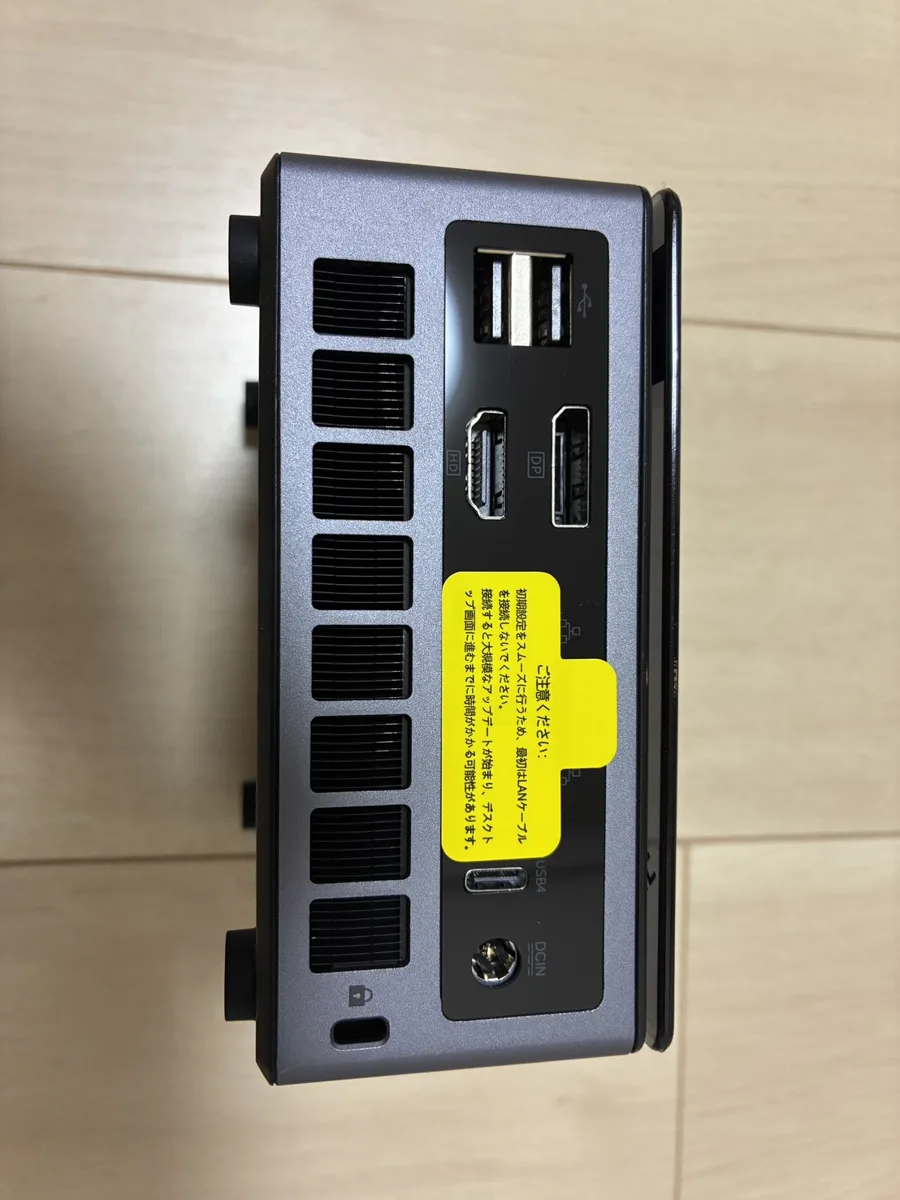
メモリはノートPC用のSO-DIMMを2枚挿す方式で、あとから交換や増設ができます。使った個体は16GB×2の32GBで、SSDのスロットも1基空いています。
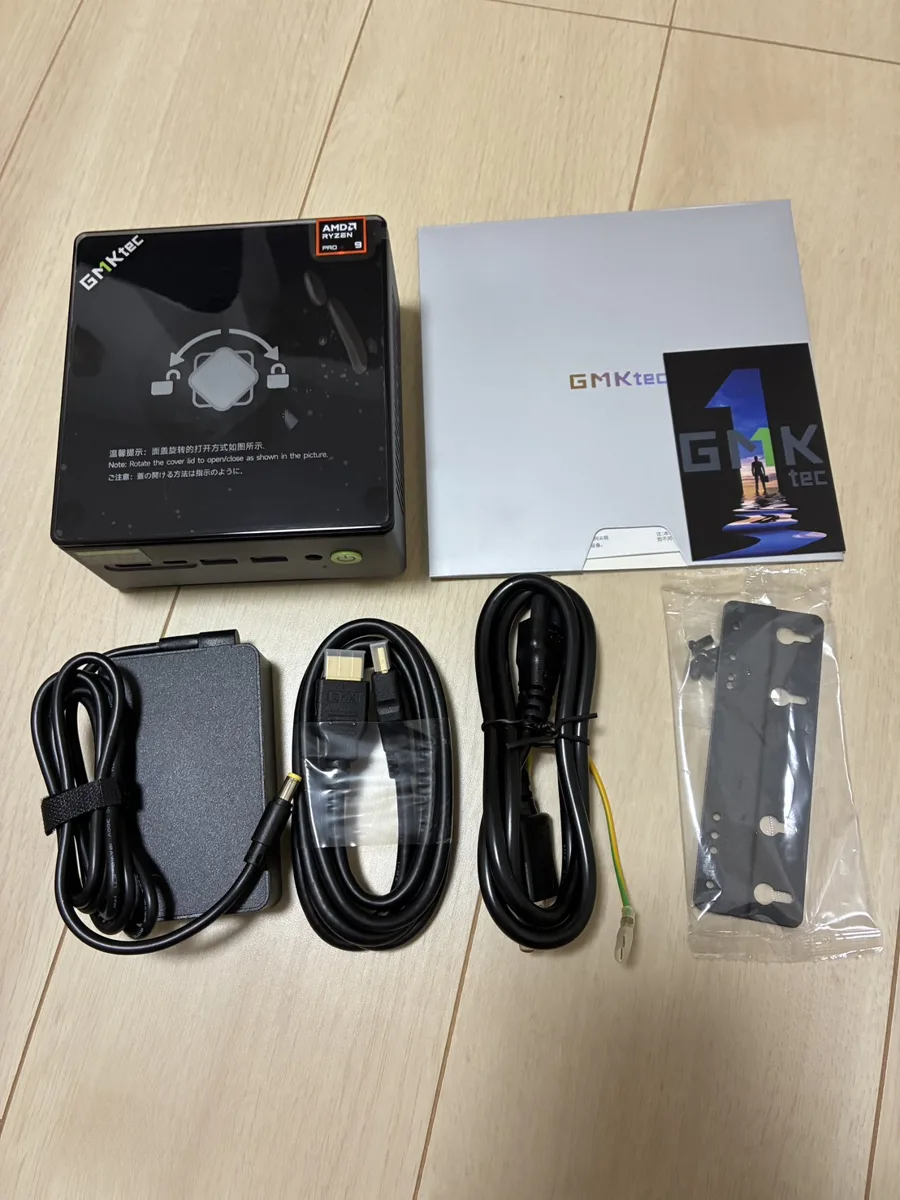
| 項目 | 公式の仕様 | 使った個体 |
|---|---|---|
| CPU | Ryzen 9 PRO 6950H(8コア16スレッド・最大4.9GHz・35〜70W) | 同じ(BIOS 1.01) |
| 内蔵GPU | Radeon 680M(12CU・最大2,400MHz) | ドライバー 32.0.21030.2001 |
| メモリ | DDR5-4800 SO-DIMM×2(最大64GB) | 16GB×2=32GB |
| SSD | M.2 2280×2(PCIe 4.0 x4対応)、標準はPCIe 3.0の1TB | UDSS UD2CMAGQ10A-001T(1TB)、1基は空き |
| 無線 | Wi-Fi 6(Intel AX200)・Bluetooth 5.2 | 同じ |
| 有線LAN | 2.5GbE×2(Intel I226-V) | 同じ |
| 拡張端子 | USB4×2、OCuLink(PCIe 4.0 x4) | 同じ |
| 電源 | 120WのACアダプター | 同じ |
※公式の仕様はGMKtecの製品ページ、使った個体の構成はWindowsのシステム情報で確認した値です(2026年10月)。
CPUの電力はBIOSで35〜70Wの範囲から選べる仕様です。この個体の記録では、負荷が高いときのチップ全体の電力が約54Wで頭打ちになっていました。OCuLinkは外付けのグラフィックボードをつなぐための端子で、電源が入ったまま抜き差しできません。
10月8日時点で、Amazon.co.jpとGMKtec JP公式ストアのどちらにもM7 Proの出品はありません。同じRadeon 680Mを積む機種では、Ryzen 7 PRO 6850HのM7と、Ryzen 7 PRO 6850UのM7 Ultraが国内で買えます。M7 Ultraの性能はM7 Ultraの検証記事で確かめています。
ローカルLLMMoEモデルなら毎秒20トークン超、14Bの通常モデルは毎秒7.2トークン
Radeon 680MはAMDのGPU計算基盤「ROCm」のWindows版(HIP SDK)の対応GPUに入っていません。そのため、GPUの汎用APIであるVulkanで動く版のllama.cpp(b11401)を使い、モデルの全層をGPUに載せて測りました。数値は、自動処理を止めた深夜に3回ずつ回した平均です。
| モデル | 生成速度 | プロンプトの読み込み |
|---|---|---|
| Qwen3-30B-A3B MoE・Q3_K_XL・13.8GB | 毎秒23.0トークン | 毎秒214トークン |
| gpt-oss-20b MoE・MXFP4・12.1GB | 毎秒21.5トークン | 毎秒301トークン |
| Gemma 4 26B-A4B MoE・Q4_0・14.6GB | 毎秒20.6トークン | 毎秒226トークン |
| Qwen3-8B 通常・Q4_K_M・5.0GB | 毎秒13.4トークン | 毎秒197トークン |
| Qwen3-14B 通常・Q4_K_M・9.0GB | 毎秒7.2トークン | 毎秒106トークン |
※プロンプトの読み込みは512トークン、生成は128トークンで測った値です。サイズはモデルファイルの大きさです。
パラメータの数が大きいMoEモデルのほうが、8Bの通常のモデルより1.5倍以上速く文章を書き出しました。内蔵GPUで文章を生成する速さは、1トークンごとにメモリから読む重みの量でほぼ決まるからです。通常のモデルは毎回すべての重みを読みますが、MoEモデルが1トークンで動かすのは一部だけです。Qwen3-30B-A3Bは305億のうち33億、gpt-oss-20bは210億のうち36億、Gemma 4 26B-A4Bは252億のうち38億のパラメータしか使いません。
生成速度の上限の目安は、メモリの帯域をモデルの大きさで割った値です。M7 ProのメモリはDDR5-4800の2枚組で、理論上の帯域は76.8GB/sです。5.0GBのQwen3-8Bなら上限は毎秒約15トークンで、実測の13.4トークンはその約9割でした。メモリの容量ごとに動くモデルの目安は、LM Studio Bionicの必要スペックにまとめています。
載せられるモデルの大きさは、メモリの容量で決まります。32GBの構成では、llama.cppから見えるGPU用のメモリが約18.7GBでした。14.6GBのGemma 4 26B-A4Bまでは、全層をGPUに載せて動きました。Qwen3-30B-A3Bの標準的な4ビット版は18.6GBで、GPU用のメモリとほぼ同じ大きさになり余裕が残らないため、少し小さい3ビット版(Q3_K_XL)で測っています。16GB構成のままでは、表のMoEモデルはどれも全層をGPUに載せられません。
常時稼働平均10.1Wで、電気代の目安は月約330〜580円
自動処理を止めずに、10月6日22時半から約36時間、CPUと内蔵GPUを合わせたチップ全体(SoC)の電力と温度を5秒ごとに記録しました。値はセンサーをソフトで読んだもので、コンセント側で測った値ではありません。
| 状態 | SoCの電力 | CPUの温度 |
|---|---|---|
| 自動処理を止めたアイドル 10分間の平均 | 7.0W | 44.7℃ |
| 約36時間の平均 自動処理を動かしたまま | 10.1W | 49.8℃(最高92.8℃) |
| 処理が一番多い1時間 10月6日14〜15時 | 32.0W | 79.3℃(最高93.0℃) |
| ローカルLLMの実行中 5モデルの計測中 | 平均33〜46W(最大約54W) | 最高90.6℃ |
※電力と温度はLibreHardwareMonitorでSoCのセンサーを読んだ値です。温度はCPUの制御用の温度(Tctl)です。
約36時間のうち、SoCの電力が10W未満だった時間が75%を占め、30Wを超えた時間は2%でした。グラフで一番高い14時台でも平均21.9Wです。忙しい時間帯の負荷は大きくても、一日をならすとアイドルに近い時間が大半になります。
電気代は、コンセント側の値を直接測っていないので、SoCの電力からの試算になります。SoCの電力だけで計算した下限は月7.3kWhで約330円になります。同じ機種の海外レビューでは、コンセント側のアイドルが約15Wでした。この個体のSoCのアイドル7.0Wとの差の約8Wを、メモリやSSD、ファン、電源の損失の分として足すと、月13.0kWhで約580円です。負荷が高い時間はACアダプターの損失も増えるので、実際はこの目安より少し上になる可能性があります。単価は1kWhあたり44.67円で計算しています(内訳はゲーミングPCの電気代の記事)。
温度は、処理が集中した1時間では全体の26%の時間が85℃を超え、最高93.0℃に達しました。ただし約36時間でならすと、85℃を超えていた時間は0.6%です。ファンは2基あり、1基は負荷に合わせて800〜2,100回転で動き、もう1基は1,700〜1,900回転でほぼ一定でした。音はフルタワーのゲーミングPCと比べると体感でかなり静かで、アイドル中なら寝室に置いてもほとんど気になりません。負荷が高い時間帯は、ファンの音が少し気になることがあります。本体やACアダプターの熱が気になったことはありませんでした。
常時稼働用に専用のミニPCを置くべきかどうかは、Claude Codeに専用ミニPCは要るのかで、クラウドで足りる場合と比べて判断できます。
トラブル1か月で起きたのは「@が打てない」「メモリが減る」「ディスクが重い」の3つ
初期設定で「@」が入力できない
セットアップの直後、日本語配列のキーボードで「@」が入力できませんでした。海外メーカーのPCで起きやすい、キーボードの種類の設定が原因です。「設定」→「時刻と言語」→「言語と地域」で日本語の「…」から「言語のオプション」を開き、キーボードのレイアウトを「日本語キーボード(106/109キー)」に変えて再起動すると直ります。
使っていないメモリが日ごとに減っていく
使い始めて約1か月のあいだ、空きメモリが日ごとに減り、再起動するまで戻らない症状が続きました。調べると、終了したはずのプログラムがメモリ上に残り続けていて、再起動から17時間で約26万個たまっていました。内蔵GPUを無効にすると増えなくなり、有効に戻すとまた増えたため、AMDのグラフィックスドライバー(31.0.24019.1006)が原因と判断できました。Windows Updateで32.0.21030.2001に更新したあとは増えていません。同じ症状が出たら、デバイスマネージャーの「ディスプレイ アダプター」からドライバーの版を確かめてください。
ディスクの使用率が100%に張り付く
9月26日から10月4日まで、読み書きの量は少ないのに、ディスクの使用率が100%に張り付いて動作が重い状態が続きました。このとき内蔵SSDは、書き込みを確定させる1回の処理に1〜2秒かかる状態になっていて、SSDの健康状態(S.M.A.R.T.)は正常でした。電源を完全に切ってから入れ直すと戻り、再起動では戻りません。10月4日に電源を入れ直し、あわせてWindowsの電源設定でNVMe SSDの省電力の切り替えを止めてからは、10月8日まで再発していません。どちらが効いたのかは分かっていないので、同じ症状が出たら、まずシャットダウンしてから電源を入れ直してください。続くようなら、空いているM.2スロットに別のSSDを足すことも選べます。
SSD連続読み込みは2,662MiB/s、書き込みの直後はランダム読み込みが26%落ちる
内蔵SSDの速さを、MicrosoftのDiskSpdで8GiBのファイルを使って測りました。キャッシュを使わない設定で、各30秒の値です。
| テスト | 読み込み | 書き込み |
|---|---|---|
| 連続(1MiB・Q8T1) | 2,662 MiB/s | 2,061 MiB/s |
| ランダム4K(Q32T1) | 149 MiB/s | 149 MiB/s |
| ランダム4K(Q1T1) | 138 MiB/s | 143 MiB/s |
※DiskSpd 2.3、自動処理を止めた状態で測った値です。読み込みは、書き込みのあと5分休ませてから測っています。
連続の読み込みはPCIe 3.0のSSDとして標準的な速さです。気をつけたいのは、大量に書き込んだ直後です。書き込みのテストのすぐあとに測ると、ランダム4K(Q32T1)の読み込みが110MiB/sと26%落ち、5分休ませると149MiB/sに戻りました。大きなファイルを書き込んだ直後に動作が重く感じても、少し待てば戻ります。
比較LLMを速くするならRadeon 780M機かRyzen AI Max+機との違いを見る
内蔵GPUでLLMを動かすときの生成速度の上限は、メモリの帯域に比例します。同じRadeon 680Mの兄弟機は帯域もM7 Proと同じで、DDR5-5600のRadeon 780M機は約1.2倍、Ryzen AI Max+機は約3.3倍です。
| モデル | GPU・メモリ | メモリ帯域(理論値) |
|---|---|---|
| GMKtec M7 Pro Ryzen 9 PRO 6950H | Radeon 680M、DDR5-4800 32GB | 76.8GB/s(実測の基準) |
| GMKtec M7 Ryzen 7 PRO 6850H | Radeon 680M、DDR5-4800 16GB(8GB×2) | 76.8GB/s |
| GMKtec M7 Ultra Ryzen 7 PRO 6850U | Radeon 680M、DDR5-4800 32GB | 76.8GB/s |
| GMKtec K8 Plus Ryzen 7 8845HS | Radeon 780M、DDR5-5600 32GB | 89.6GB/s(約1.2倍) |
| MINISFORUM MS-S1 MAX Ryzen AI Max+ 395 | Radeon 8060S、LPDDR5X-8000 64GB | 256GB/s(約3.3倍) |
※メモリ帯域は、DDR5は2枚組(128bit)、LPDDR5Xは256bitとして計算した理論値です。
結論M7 Proが向いている人・向いていない人
- 自動処理や家庭内サーバーを24時間動かしたい人(平均10W前後で動く)
- 20〜30B級のMoEモデルを毎秒20トークン前後で使えれば十分な人
- メモリやSSDをあとから自分で増やしたい人(SO-DIMM×2・M.2×2)
- 寝室や机の上に置いても静かなPCが欲しい人
- 14B以上の通常のモデルを快適に使いたい人(毎秒7トークン台)
- 70B級のモデルを動かしたい人(容量も帯域も足りない)
- 新品を国内の通販ですぐ買いたい人(M7 Proは出品なし)
- ゲームを主な目的にする人(Radeon 780M以上の機種が向く)
おすすめ今買えるミニPCから用途で選ぶ
M7 Proの新品は国内で手に入りにくいので、同じRadeon 680Mの兄弟機と、LLMを速くできる機種から選びます。常時稼働とローカルLLMの両方が目的なら、メモリを32GB以上にできることが条件です。


※価格・在庫は変動します。最新の価格はAmazonの商品ページでご確認ください。
FAQよくある質問
まとめまとめ|M7 Proは24時間動かすサーバーと軽めのローカルLLMに向く
GMKtec M7 Proは、Ryzen 9 PRO 6950HとRadeon 680Mを積むミニPCです。約1か月、自動処理を回すサーバーとして使ったところ、チップの電力は平均10.1Wで、電気代の目安は月約330〜580円でした。ローカルLLMは20〜30B級のMoEモデルなら毎秒20トークンを超え、14Bの通常のモデルは毎秒7.2トークンにとどまります。
国内では新品を手に入れにくいので、同じ使い方をするなら、同じRadeon 680MのM7かM7 Ultraを選んでください。LLMの生成をもっと速くしたいならDDR5-5600のRadeon 780M機、70B級まで動かすならRyzen AI Max+機が候補です。
M7 Proは「一日中つけておく小さなサーバー」として優秀でした。平均10W前後で動き、寝室に置いても気にならない静かさです。ローカルLLMはMoEモデルを選べば実用的な速さで動きますが、大きなモデルを速く動かしたいなら、メモリの帯域が広い機種を選ぶ必要があります。
出典:GMKtec NucBox M7 Pro 製品ページ、Virtualization Howto GMKtec NUCBOX M7 Pro レビュー、AMD ROCm HIP SDK for Windows 動作要件、llama.cpp(GitHub)、Qwen3-30B-A3B モデルカード、gpt-oss-20b モデルカード、Gemma 4 26B A4B モデルカード、DiskSpd(GitHub)
あわせて読みたい






Amazonの価格・在庫情報について



Amazonの価格・在庫情報について