GMKtec EVO-X5 Proを5台・20台つなぐと何ができる?合計960GBの意味と、複数台でLLMを動かす条件【2026年10月】
本記事にはアフィリエイト広告(Amazon・楽天市場等)のリンクが含まれています。
合計960GBは「1つの大きなメモリ」ではなく、モデルを台ごとに分けて持つ使い方
出典(確認日2026年10月10日):AMD「Trillion-Parameter LLM on an AMD Ryzen AI Max+ Cluster」、中関村在线(ZOL)「GMK极摩客×AMD×京东 10月9日新品发布会举行」、GMKtec公式「GMKtec Unveils EVO-X5 Pro at IFA 2026」、TechPowerUp「GMKtec Launches EVO-X5 Pro」(プレスリリース)、GMKtec JP公式「EVO-X5 Pro」製品ページ、llama.cpp「RPC backend」README
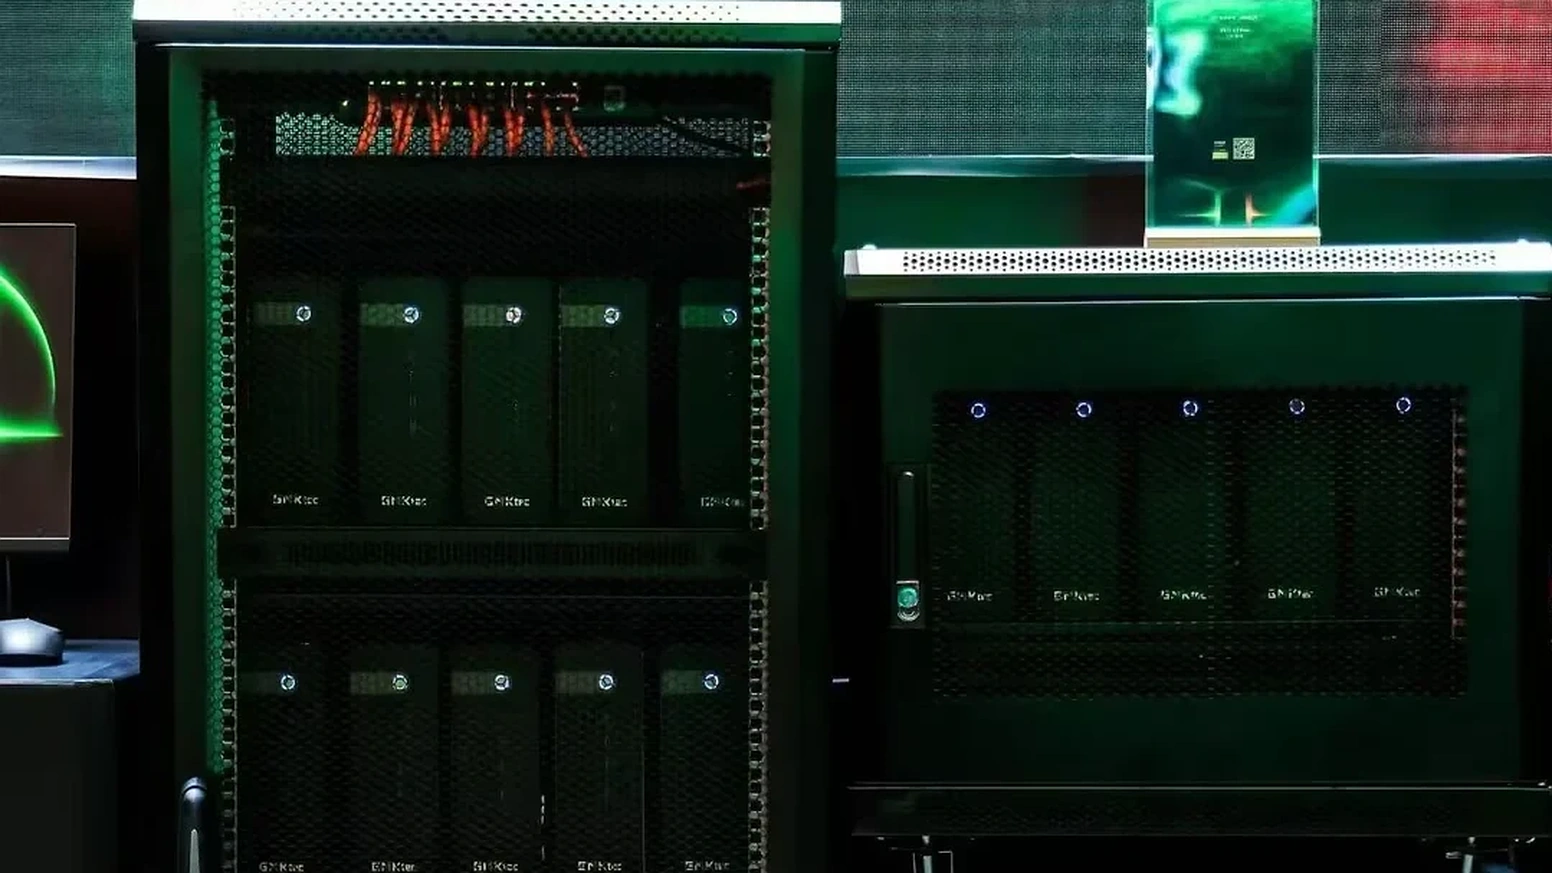
EVO-X5 Proは1台で192GBのユニファイドメモリを積み、そのうち最大160GBをグラフィックスメモリにできるミニPCです。GMKtecが10月9日に深圳で開いた発表会では、この機体を5台つないで合計960GB、20台つないで合計3.84TBにした構成が展示されました。数字だけを見ると、巨大なモデルがそのまま1台のように動くと受け取りたくなります。
実際には、メモリは1つに合体しません。複数台でLLMを動かす方法は2つあり、1つのモデルを台ごとに分けて持つ使い方なら、1台に入らない大きなモデルが動きます。ただし台の間をネットワークが結ぶぶん、1台のときより遅くなります。AMDが公開した、Ryzen AI Max+の4台構成で1兆パラメーター級のモデルを動かした例では、文章の生成は毎秒9トークン前後、4,096トークンの入力を読み込むのに約40秒かかっています。
1台100万円前後の機体を複数台にする意味があるのは、160GBを超えるモデルを動かしたい人と、社内の複数人で使いたい組織です。個人が160GBに収まるモデルで使うなら、台数を増やしても速くはなりません。つなぎ方はUSB4直結か10GbEで、台数ごとの本体価格は5台で約515万円、20台で約2,060万円(SSDなし構成)です。
目次
要点まず何が新しく出たか
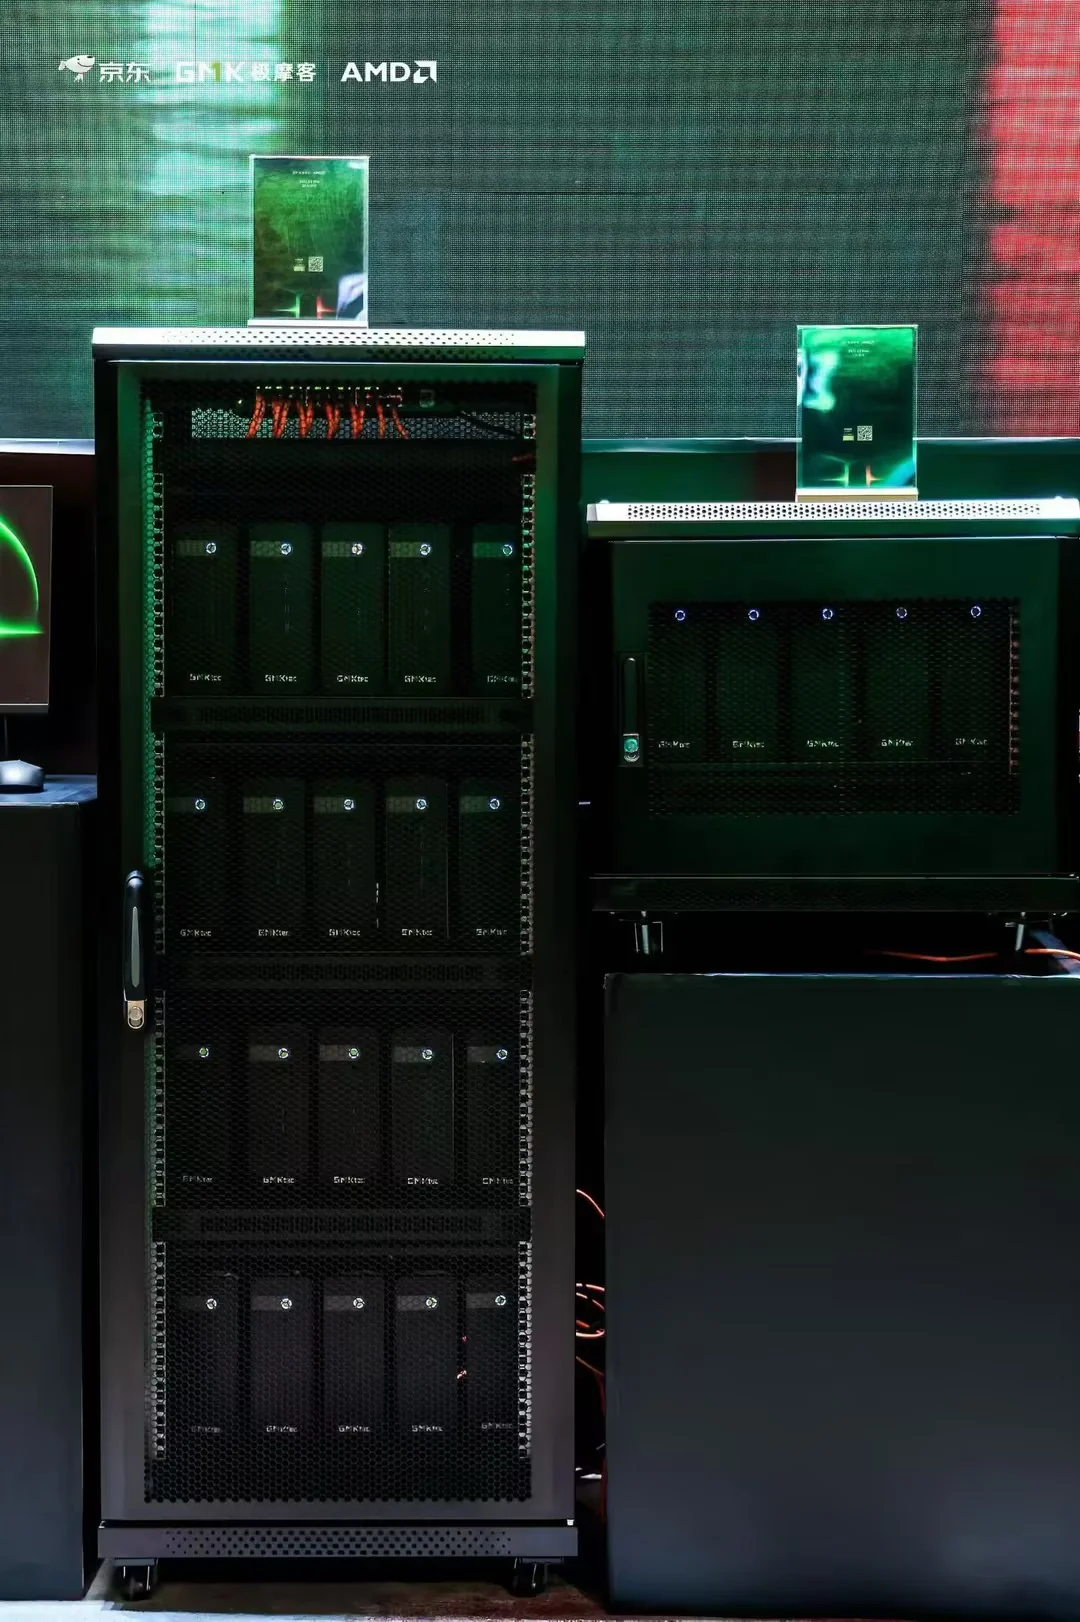
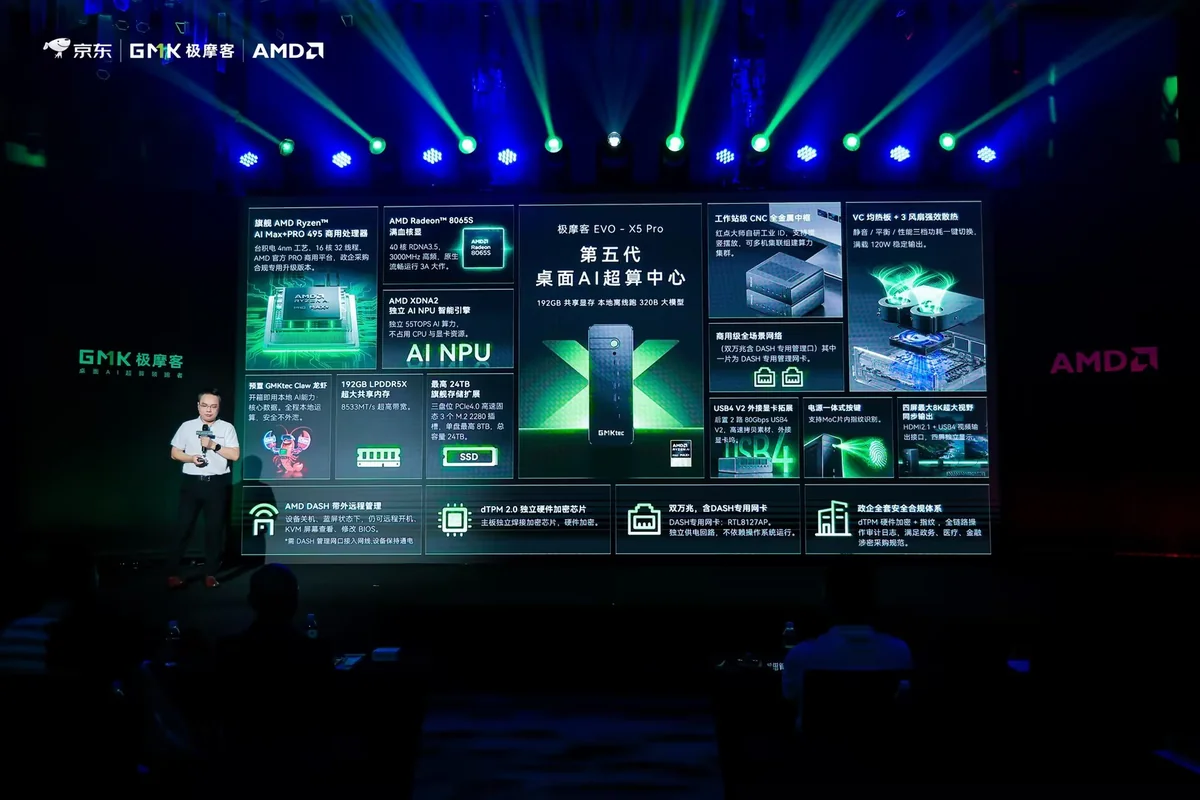
GMKtecは10月9日の中国発表会で、EVO-X5 Proを「商用のAI計算ノード」として打ち出しました。5台構成で合計最大960GB、20台構成で合計3.84TBの物理メモリを実機で展示し、5台は社内向けのプライベートAI・AIエージェント・モデル検証用、20台はAI教育・研究・複数ユーザー向けと説明しています。このほか、OSに依存せず遠隔で電源・画面・BIOSを操作できるAMD DASH、専用のdTPM 2.0、電源ボタンの指紋認証、管理専用の10GbEポートが挙げられています。
発表会10月9日の中国発表会で明らかになったこと
発表会は京東(JD.com)、GMKtec、AMDの3社名義で、中国では京東が独占販売します。
1つ目は企業向けの管理機能です。AMD DASHは、OSが起動していなくても管理者が遠隔から電源操作・KVM(画面とキーボードの遠隔操作)・BIOS設定・復旧を行える仕組みです。発表会のスライドには、DASHを使うには「電源が入った状態で管理用ポートをネットワークにつないでおく必要がある」という注記があります。10GbEのポートは2つありますが、スライドではそのうち1つがDASH専用の管理ポートで、データ通信用に使えるのは残り1つと読めます。複数台をLANでつなぐ場合は、この1ポートを台間の通信に使う前提で考えることになります。
EVO-X5 ProのIFAでの発表と展示機の盗難の経緯はIFAでの発表の記事にあります。
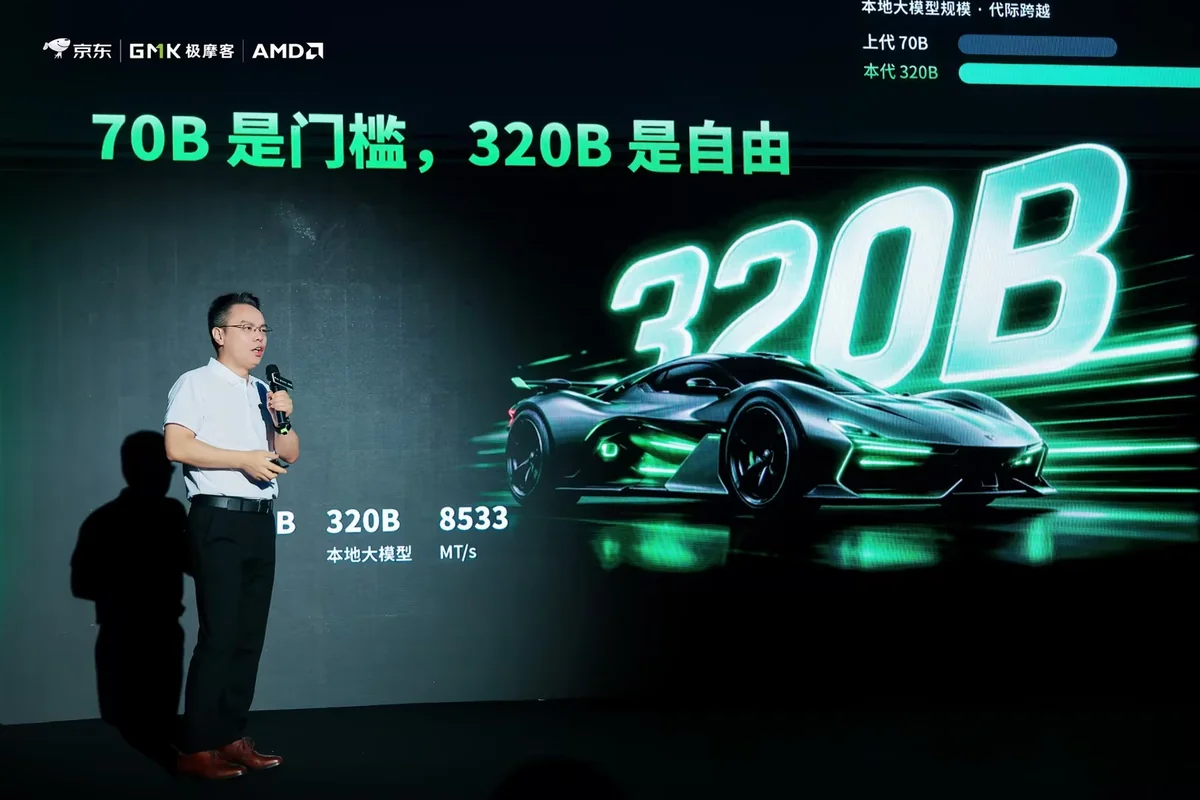
2つ目は規模の目標です。当初は3,000億パラメーターを目標に開発し、最適化の結果、最大3,200億パラメーターのオフライン推論に対応したと説明しています。ただしGMKtecは「モデル・ソフト・量子化・負荷による」と条件を付けています。スライドでは前世代(EVO-X2)の70Bに対して今世代は320Bという比較が示されましたが、320Bの重みは4ビット量子化でそれだけで約160GBになり、1台のVRAMの上限にちょうど達してしまいます。コンテキスト用の余裕を残すには、4ビットより強く圧縮したモデルが前提と考えるのが自然です。
3つ目が5台・20台の構成です。5台構成の説明は「高速な相互接続で複数ノードのメモリと計算資源を協調させ、より大きなモデルをローカルで動かす」、20台構成は「統一的な編成と集中管理で、複数ユーザーの実験環境を1つの基盤で管理する教育用の計算プール」でした。20台のほうは、授業や課題ごとにCPU・メモリ・GPUを割り当てる使い方で、オフラインのモデル置き場やローカル認証と組み合わせると紹介されています。
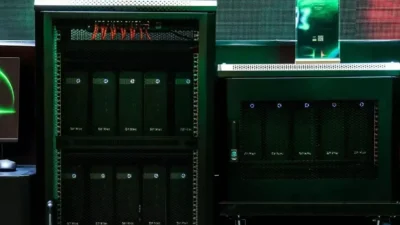
GMKtecの発表資料と中国の報道には、台どうしをつないだ方法(スイッチ・10GbE・USB4のどれか)と、モデルを動かしたソフトの名前が書かれていません。展示のラックの上部にはネットワーク機器のようなものとケーブルが写っていますが、規格までは読み取れません。接続の実例としては、AMDが公開した別機種の手順が参考になります。
仕組み960GBは「1つの大きなメモリ」ではない
1台あたりのメモリは192GBで、5台なら192×5=960GB、20台なら192×20=3,840GBです。この足し算自体は正確ですが、複数台のメモリがOSの目から1つの領域に見えるようになるわけではありません。複数台でLLMを動かす使い方は2つに分かれます。
| 使い方 | 何が起きるか | 向いている目的 |
|---|---|---|
| 1つのモデルを台ごとに分けて持つ | モデルの層を複数の台に振り分けて持ち、1回の生成ごとに台の間でデータをやり取りします。1台に入らない大きなモデルが動きますが、台の間の通信がそのつど挟まるため、1台のときより遅くなります | 160GBを超える巨大なモデルを動かしたい |
| 台ごとに別のモデル・別の利用者を受け持つ | 各台が自分のメモリに収まるモデルを単独で動かします。台の間の通信は要らないため、台数に比例して同時に使える人数やモデルの数が増えます。1つの質問が速くなるわけではありません | 複数人で使う、複数のモデルを同時に動かす |
GMKtecが20台構成の用途に挙げた「教育・研究・複数ユーザー」は、2つ目の使い方に近い説明です。一方、5台構成の「より大きなモデルをローカルで動かす」は1つ目にあたります。
1台で最大160GBをグラフィックスメモリに割り当てられるため、5台なら単純な足し算で800GBです(割り当ての方法はRyzen AI MaxのVRAM割り当ての解説にまとめています)。ただし、モデルの重みをそのまま5台に均等に割るわけではなく、実際には各台にコンテキスト(会話の履歴)用の領域や、OSが使う分も残す必要があります。800GBは「重みの上限」ではなく、「重みとコンテキストをあわせて置ける目安」と受け取ってください。
実例AMDの4台構成では毎秒約9トークン、読み込みに約40秒
複数台でLLMを動かす手順は、AMDが2026年2月に公開しています。Framework Desktop(Ryzen AI Max+ 395・128GB)を4台、5ギガビットのイーサネットでつなぎ、llama.cppのRPCという仕組みで、1兆パラメーター級のKimi K2.5(2ビット級の量子化で約375GB)を動かしました。1台がモデル全体の指揮をとり、残りの3台がメモリと計算力を提供します。
| 測定項目 | 条件 | 結果 |
|---|---|---|
| 文章の生成速度 | 128トークンを生成(Flash Attention有効) | 毎秒9.45トークン |
| 長い履歴での生成速度 | 履歴が8,192トークンのとき | 毎秒8.30トークン |
| 最初の1文字が出るまで | 入力4,096トークン | 39.7秒 |
| 最初の1文字が出るまで | 入力8,192トークン | 90.5秒 |
| 最初の1文字が出るまで | 入力16,384トークン | 239.1秒 |
毎秒9トークン前後は、文章を目で追える速さではありますが、対話の返事を待つには遅めです。もう1つ重要なのが入力の読み込みで、プロンプトが長くなるほど待ち時間が急に伸びます。コードや資料を丸ごと渡して使うエージェント用途では、最初の1文字が出るまでに数分かかる場合があるということです。
AMDは、1台あたりBIOSでグラフィックスメモリに割り当てられる上限を96GBと書いています。Linuxでは起動設定を変えることで1台120GBまで広げ、4台で480GBにしています。1台の上限が足りなければ台数で補う、という考え方です。EVO-X5 Proは1台で160GBまで割り当てられるため、同じ約375GBのモデルなら、重みだけを見れば3台分(480GB)に収まる計算です。
AMDの手順は、Ryzen AI Max+ 395とLinux(Ubuntu)、ROCmの組み合わせで確かめられたものです。EVO-X5 Pro自体で同じ手順を試した資料は、今回確認した範囲にはありません。また、使われているllama.cppのRPCは、開発元が「試作段階で不安定、安全でもない」と明記しており、信頼できないネットワークや重要なデータを扱う環境には置かないよう求めています。
接続台どうしをつなぐ方法で速度の上限が決まる
1つのモデルを台ごとに分ける場合、台の間の通信速度が速度を左右します。EVO-X5 Pro 1台の中のメモリは、LPDDR5X-8533の256ビットで毎秒約273GBです。台の間をつなぐ経路は、これよりずっと細くなります。
| 経路 | 速さ(規格上の上限) | 台内メモリに対する比率 |
|---|---|---|
| 1台の中のメモリ | 約273GB/s | 1 |
| USB4 V2(80Gbps) | 約10GB/s | 約1/27 |
| 10GbE | 約1.25GB/s | 約1/220 |
| 5GbE(AMDの4台構成) | 約0.6GB/s | 約1/440 |
EVO-X5 ProにはUSB4 V2(80Gbps)が2つあり、10GbEは2つのうち1つがDASH専用です。台の間を10GbEでつなぐなら、AMDの例の5GbEの2倍の帯域になります。USB4で2台を直結する方法もありますが、規格上の80Gbpsがそのまま出るとは限りません。Framework Desktopの例では、USB4での2台直結はBIOSの改良で約9Gbpsから約30Gbpsに上がったと伝えられています。EVO-X5 Proの実測は見つかっていないため、USB4での速度は未確認の扱いです。
3台以上をつなぐ場合、USB4は直結できる相手が限られるため、スイッチを介する10GbEが現実的な選択肢になります。10GbEのスイッチは台数ぶんのポートが要るので、5台なら5ポート以上、管理用のDASHポートも別に配線するなら10ポート近く必要です。
10GbEで毎秒何トークン出るのかは、メーカーも第三者も公表していないため、ここで速度を見積もることはしません。AMDの毎秒9トークン前後を基準に、帯域が2倍の10GbEなら同程度かそれ以上、という程度に受け取るのが安全です。
比較他社の複数台構成との違い
ローカルLLM用に複数台をつなぐ構成は、他社も案内しています。つなぎ方の太さが大きく違います。
| 機種 | 1台の容量 | 複数台のつなぎ方 |
|---|---|---|
| GMKtec EVO-X5 Pro | 192GB(160GBをVRAMに) | USB4 V2(80Gbps)×2、10GbE×1(もう1つはDASH専用)。展示の接続方法は未公表 |
| Framework Desktop 192GB | 192GB | 50ギガビットのネットワークカードとRDMAで接続すると、2台で合計384GBのモデルを分担。USB4直結は約30Gbps |
| NVIDIA DGX Spark 64GB版 | 64GB | ConnectX-7(200Gbps)で2台をつなぐと128GB。NVIDIAの測定で1台の最大1.7倍の速さ |
FrameworkはEVO-X5 Proと同じチップを積みながら、メインボードのPCIeスロットに高速なネットワークカードを挿す前提で、台の間の帯域を10GbEの数倍に引き上げられる設計です。DGX Sparkは本体にConnectX-7を内蔵し、2台の接続をNVIDIA Syncが自動で設定します。それぞれの詳細はFramework Desktop 192GBの解説とDGX Spark 64GB版の解説にあります。
EVO-X5 Proの強みは、PCIeスロットに頼らずUSB4 V2が最初から2つ付いていることと、DASHによる遠隔管理が標準で付く点です。台数を増やしたときの管理の手間では、こちらが有利です。台の間の帯域を最優先するなら、Frameworkに50ギガビットのカードを足す構成のほうが太い通信路を確保できます。
同じRyzen AI Max+ PRO 495を積む192GB機にはACEMAGIC F9Aもあり、同じチップのミニPCの選び方はRyzen AI Maxミニの選び方で比べています。メモリ128GBのRyzen AI Max+ 395機(MINISFORUM MS-S1 MAXなど)は、1台あたりの購入額を抑えて複数台の挙動を試したい人の候補です。

価格5台で約515万円から、中国の価格は日本とほぼ同水準
日本の公式ストアの表示価格は、10月10日時点で192GB+SSDなしが1,029,990円、192GB+2TBが1,087,840円、192GB+4TBが1,135,840円です。10月1日に確認した価格より約3万円上がっています。この表示価格に、税や関税が含まれるとは限りません。
| 台数 | SSDなし(日本の表示価格) | 2TB構成(日本の表示価格) |
|---|---|---|
| 1台 | 1,029,990円 | 1,087,840円 |
| 5台(合計960GB) | 約515万円 | 約544万円 |
| 20台(合計3.84TB) | 約2,060万円 | 約2,176万円 |
上の台数分の金額は本体の単純な掛け算で、10GbEのスイッチやケーブル、ラックは含みません。中国では京東が10月9日に予約を始め、192GB+2TBが46,999元、192GB+4TBが49,999元です。2026年10月10日の為替レート(1元=約23.6円)で換算すると約111万円と約118万円で、日本の表示価格(約109万円と約114万円)とほぼ同じ水準です。中国の京東の発売には、電源の無料アップグレードや開始直後の購入者向けの贈呈品などの特典が付いています。
1台の価格の比較や、同じチップを積む他社機の価格差は、EVO-X5 Proの発売と価格の記事にまとめています。
判断複数台にするのは、160GBを超えるモデルが必要な人と組織
- 160GBを超えるモデルを、データを外に出さずに動かしたい
- 社内の複数人が同時にローカルLLMを使い、台ごとに利用者を分けたい
- DASHで遠隔管理できる台数分の設置場所とネットワーク機器を用意できる
- LinuxでROCmとllama.cppを自分で組める技術者がいる
- 160GBに収まるモデルを1人で使う(台数を増やしても速くならない)
- 対話の応答速度を重視する(台の間の通信で遅くなる)
- ゲームも兼ねたい(複数台にする利点が出ない)
- 複数台の動作確認が済んでいない段階で、5台分の500万円台を先に払うのは避けたい
個人が2台目を足す場合は、まずUSB4での直結を試し、足りなければ10GbEのスイッチを加える順番が現実的です。ただしEVO-X5 ProのUSB4直結での実測は見つかっていません。複数台を前提に買うなら、1台で動作を確かめてから台数を増やしてください。
おすすめまずは1台で160GBの限界を確かめる
複数台の効果は、1台の160GBに収まらないモデルを実際に動かして初めて分かります。最初の1台はSSD容量だけ違う2構成のどちらかで、SSDは数十GB単位のモデルを複数置くなら4TBが安心です。

まとめまとめ|960GBは分けて持つメモリ、個人は1台で160GBまで
5台で960GB、20台で3.84TBという数字は、台ごとのメモリを足した合計です。1つのモデルを分けて動かせば1台に入らない大きなモデルが動きますが、AMDの4台構成の実測は毎秒約9トークン、4,096トークンの入力で約40秒の待ち時間でした。台ごとに別のモデルや利用者を受け持たせる使い方なら、速度を落とさずに同時に使える人数を増やせます。
個人は1台の160GBに収まるモデルまでで十分です。160GBを超えるモデルを動かしたい人と、社内で複数人が使う組織が、複数台の対象です。台の間のつなぎ方と10GbEでの実測は未公表のため、5台をまとめて買う前に、1台で動作を確かめてください。
あわせて読みたい



Amazonの価格・在庫情報について


Amazonの価格・在庫情報について