DGX SparkとRTX 5090の違い|ゲームは動く?AIの生成速度は5090が4〜6倍、64GB版を別に置くべき人【2026年10月】
本記事にはアフィリエイト広告(Amazon・楽天市場等)のリンクが含まれています。
AIの生成速度は5090が4〜6倍、ゲームは動くがRTX 4060以下
NVIDIAは2026年10月2日、小型AIコンピューター「DGX Spark」に、メモリを64GBにした新モデルを追加すると発表しました。10月23日に4,999ドルから発売されます。GPUはGeForce RTX 5090と同じBlackwell世代で、「AIスーパーコンピューター」をうたう製品ですが、RTX 5090のゲーミングPCよりAIが速いわけでも、ゲーミングPCの代わりになるわけでもありません。
32GBに収まるモデルなら、ローカルLLMの生成速度はRTX 5090のほうが4〜6倍速く出ます。メモリの帯域がRTX 5090の1,792GB/sに対して、DGX Sparkは273GB/sしかないためです。ゲームもArm版のSteamが非公式に動く段階で、フレーム生成を使わない1080pのCyberpunk 2077はRTX 4060より遅い結果が出ています。
DGX Sparkに意味があるのは、32GBを超えるモデルやAIエージェントを、CUDAで常に動かしておきたい場合です。その場合もゲーミングPCを置き換えるのではなく、横にもう1台置く形になります。CUDAにこだわらないなら、128GBのRyzen AI Max+ 395搭載ミニPCのほうが安く大容量のメモリをそろえられます。
目次
結論先に結論|ゲーミングPCで足りる人とDGX Sparkが要る人
- ゲームが主で、AIは画像生成や7B〜30BクラスのLLMを試す程度
- 使うモデルがVRAM(RTX 5090なら32GB、RTX 5080なら16GB)に収まる
- Windowsでゲームも作業も1台で済ませたい
- 70Bクラスや1,000億パラメータ前後のMoEモデルなど、32GBを超えるモデルを常駐させたい
- コーディングや調査のAIエージェントを24時間動かし、ゲーミングPCのGPUを空けておきたい
- CUDAとNVIDIAのAIソフト一式を前提に開発する
新モデルDGX Spark 64GBは128GB版とチップが同じでメモリが半分
DGX Sparkは、20コアのArm CPUとBlackwell世代のGPUを1つにまとめた「GB10 Grace Blackwell Superchip」を積む小型のAIコンピューターです。本体は約15cm角・高さ約5cm、重さは約1.2kgで、電源は240Wの外付けアダプターです。
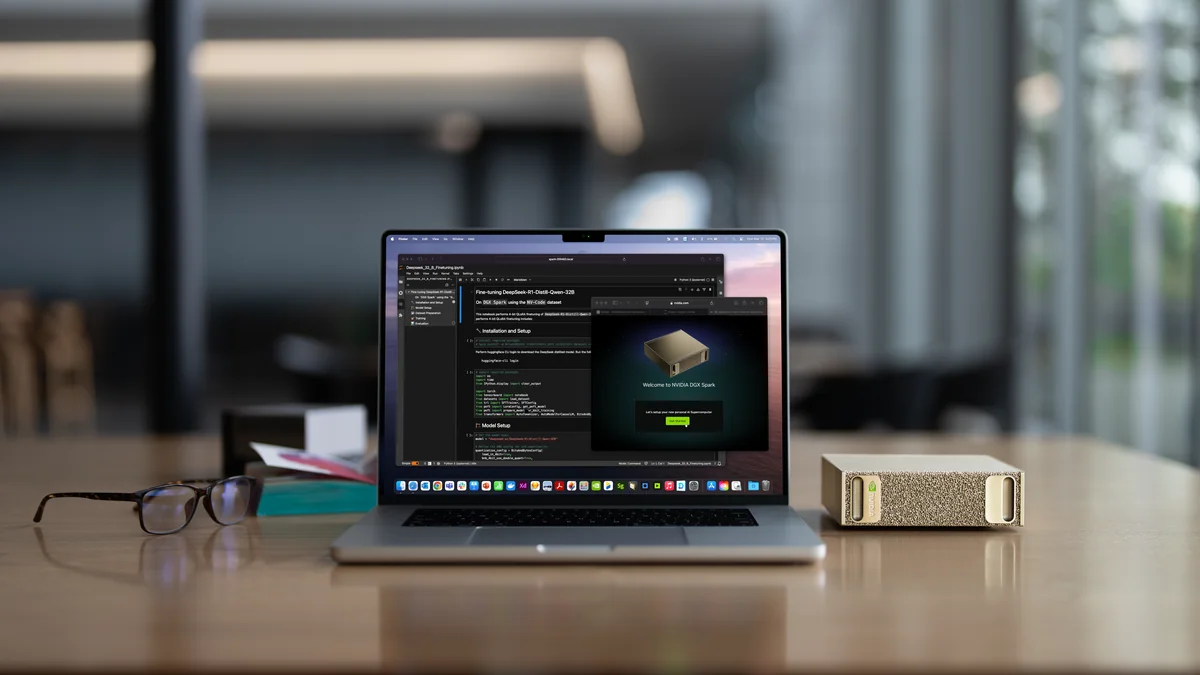
新しい64GBモデルは、GB10、OSのDGX OS、NVIDIAのAIソフト一式を128GB版と共通にしたまま、メモリだけを半分にしています。NVIDIAは、1台で最大1,000億パラメータのモデルを動かせるとしています。
2台をQSFPケーブルでつなぐと、メモリを合わせて128GBとして使えます。NVIDIAが自社でQwen 3.8 27Bを動かしたテストでは、2台構成は1台の最大1.7倍の速さでした。
販売はAcer、ASUS、Dell、GIGABYTE、HP、MSIの6社だけで、NVIDIA自身は64GB版を売りません。1年前に3,999ドルで出た128GB版よりメモリが半分なのに1,000ドル高く、NVIDIAが売る128GB版はいま6,950ドルです。日本での価格の目安と、64GB版2台と128GB版1台の損得はDGX Spark 64GB版の価格と128GB版との違いで計算しています。
スペック比較DGX Spark 64GBとRTX 5090のスペックの違い
RTX 5090はグラフィックボード単体、DGX Sparkはパソコン一式なので、AIの用途で比べるときに効くのは「AIに使えるメモリの量」と「そのメモリの速さ」の2つです。
| 項目 | DGX Spark 64GB | GeForce RTX 5090 |
|---|---|---|
| 製品の形 | 小型PC一式(CPU・GPU・メモリ・SSD込み) | グラフィックボード(CPUやメモリは別に必要) |
| AIに使えるメモリ | 64GB(CPUとGPUで共有) | 32GB GDDR7(GPU専用) |
| メモリ帯域 | 273GB/s | 1,792GB/s |
| GPU | Blackwell(CUDAコア6,144基) | Blackwell(CUDAコア21,760基) |
| CPU | 20コアのArm(Cortex-X925×10+Cortex-A725×10) | 別に用意(x86のCore Ultra・Ryzenなど) |
| OS | DGX OS(Ubuntu 24.04ベース) | Windows 11・Linux |
| 電力 | 外付け電源アダプター240W | カードだけで575W(TGP) |
| 米国価格 | 4,999ドル〜(本体一式) | 1,999ドル(発売時の希望小売価格・カード単体) |
| 扱えるモデル | 最大1,000億パラメータ(NVIDIA公称) | VRAMの32GBに収まる範囲 |
※DGX Sparkの仕様はNVIDIAのユーザーガイド(128GB版)と64GB版の発表、RTX 5090はNVIDIAの公式仕様と発売時の発表にもとづきます。
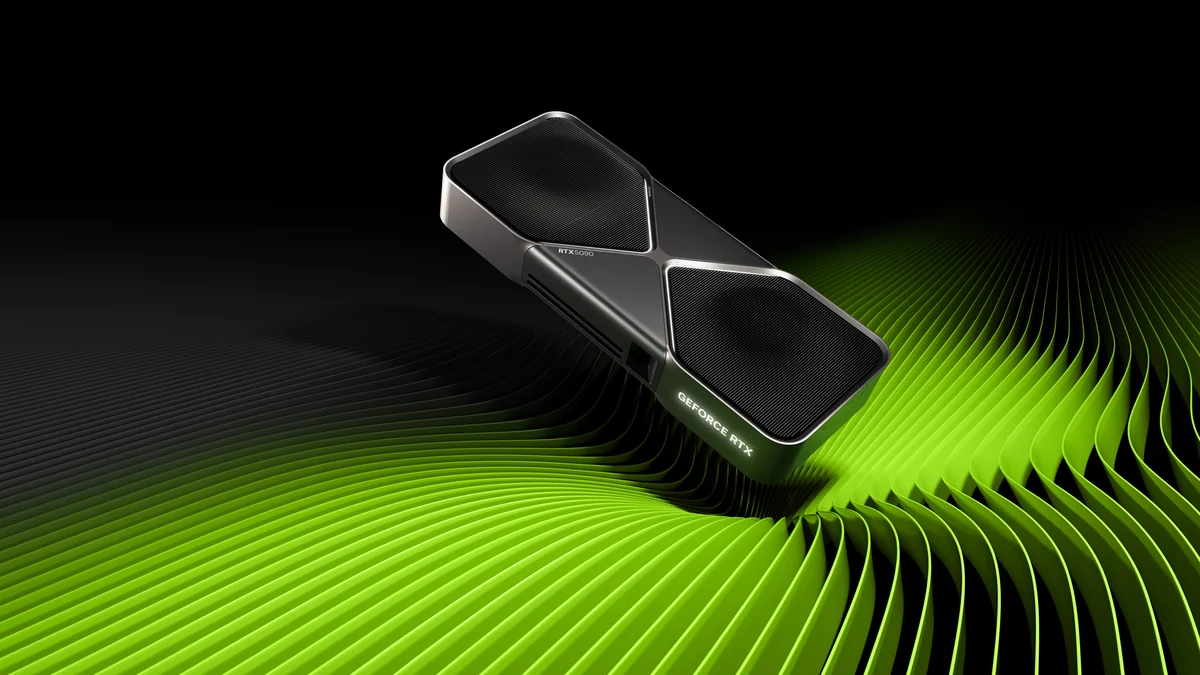
差がいちばん大きいのはメモリの帯域です。RTX 5090の1,792GB/sは、DGX Sparkの273GB/sの約6.6倍あります。GPUのCUDAコアもRTX 5090が21,760基、DGX Sparkが6,144基で、3.5倍の開きがあります。
DGX Sparkが上回るのは容量だけです。RTX 5090のGDDR7はGPU専用の32GBですが、DGX SparkはCPUとGPUが同じ64GBのメモリを共有するので、OSなどが使う分を除いた残りをモデルの置き場に使えます。
生成速度ローカルLLMの生成速度はRTX 5090が4〜6倍速い
推論エンジンSGLangの開発チームLMSYSが2025年10月に公開した計測では、32GBに収まるモデルの生成速度は、どれもRTX 5090がDGX Sparkの4〜6倍でした。条件はOllama、同時に1リクエスト、4ビット量子化のモデルです。
| モデル | DGX Spark | RTX 5090 |
|---|---|---|
| Llama 3.1 8B | 43.18 | 200.00(4.6倍) |
| Gemma 3 12B | 26.51 | 111.71(4.2倍) |
| Gemma 3 27B | 11.51 | 65.02(5.6倍) |
| Qwen 3 32B | 9.53 | 58.90(6.2倍) |
| Llama 3.1 70B | 4.58 | 32GBに収まらず計測なし |
| gpt-oss-120b MXFP4 | 41.88 64GB版には載らない | 32GBに収まらず計測なし |
※単位は1秒あたりに生成するトークン数。gpt-oss-120b以外はQ4_K_M。DGX Sparkは128GB版での計測です。64GB版も同じGB10と同じメモリ帯域なので、メモリに収まるモデルなら同じ速さになります。
差の理由はメモリの帯域です。LLMは1トークンを出すたびに、モデルの重みをメモリから読み出します。読み出しの速さがRTX 5090の約6分の1しかないDGX Sparkは、GPUの演算に余裕があっても生成が遅くなります。LMSYSも、帯域がDGX Sparkの推論性能のいちばんのボトルネックだと結論づけています。
32GBに収まるモデルで速さを求めるなら、DGX Sparkを選ぶ理由はありません。16GBのRTX 5080でも、同じ計測でLlama 3.1 8Bは毎秒134.69トークンと、DGX Sparkの3倍以上出ています。
容量32GBを超えるモデルでは立場が逆転する
RTX 5090でも動かせないのが、VRAMの32GBに収まらないモデルです。Llama 3.1 70Bは4ビットに量子化しても重みだけで約43GBあり、RTX 5090の1枚には載りません。DGX Sparkなら、64GB版でもこれをメモリに置いたまま動かせます。
ただし速さは毎秒4.58トークンで、1,000トークンの回答を出し切るのに約3分40秒かかります。70Bクラスのように全部のパラメータを毎回使う「密」なモデルは、1トークンごとに43GB近くを読み出すため、273GB/sの帯域ではこれ以上伸びません。
DGX Sparkが実用的な速さを出せるのは、MoE(専門家混合)と呼ばれる種類のモデルです。gpt-oss-120bは全体で1,170億パラメータありますが、1トークンごとに使うのは51億パラメータ分だけなので、読み出す量が少なく済みます。128GB版での生成速度は、2025年10月のLMSYSの計測で毎秒41.88トークン、2026年2月のllama.cppの公式ベンチマークでは毎秒58.72トークンでした。
そのgpt-oss-120bは重みのファイルだけで約63GBあり、64GB版1台には載りません。64GB版で動かせるのは、NVIDIAのいう1,000億パラメータまでのMoEモデルや、30B〜70Bクラスのモデルです。120Bクラスを使うなら、128GB版か64GB版2台が必要です。
RTX 5090の側にも、MoEモデルなら一部の層をメインメモリに逃がして動かす方法があります。ただし速さはCPUとメインメモリの性能に左右され、ゲームと同時に動かせばGPUとVRAMを取り合います。
収まるならRTX 5090が4〜6倍速く、DGX Sparkを選ぶ理由はありません。収まらない70Bクラスの密なモデルや、1,000億パラメータ前後のMoEモデルを1台で常駐させたいときだけ、DGX Sparkの容量が効いてきます。
ゲームDGX Sparkでゲームは動くが、Valveの公式対応ではない
Valveは、Arm版Linux向けのSteamクライアントを公式には配布していません。DGX SparkでSteamのゲームを遊ぶ方法は、UbuntuのCanonicalが配布しているArm64版のSteam snapです。x86向けのSteamとゲームをFEXで変換して動かし、Windows向けのゲームはさらにProtonを通します。
Canonicalは2026年1月にテスト版を出し、6月2日に安定版へ移しました。開発と検証は主にDGX Sparkで進められています。
CanonicalがまとめたDGX Sparkでの動作例では、Counter-Strike 2、DOTA 2、Half-Life 2が目立った性能の問題なく滑らかに動き、Cyberpunk 2077もDLSSを使って200fps以上の結果です。ただし解像度、画質設定、フレーム生成の有無は公表されていないので、素の描画性能の目安にはなりません。
フレーム生成もアップスケーリングも使わない素の描画性能は、RTX 4060より下です。GB10搭載機(128GB)の利用者が2026年6月に計測したCyberpunk 2077の平均fpsは、どの画質でもRTX 4060を下回りました。
| 画質 | GB10 | RTX 4060 |
|---|---|---|
| 低 | 75.3 | 129.9 |
| 中 | 73.6 | 99.2 |
| 高 | 62.5 | 84.1 |
| ウルトラ | 57.6 | 71.1 |
| RTウルトラ | 32.4 | 35.2 |
※Cyberpunk 2077、1920×1080、アップスケーリングとフレーム生成なしの平均fps。GB10はUbuntu 26とNVIDIAドライバー610、RTX 4060はWindows 11と同じドライバー610での計測です。
GB10は低画質と中画質のfpsがほぼ同じ(75.3と73.6)で、画質を下げてもRTX 4060のようには伸びません。差がいちばん大きいのは低画質で、RTX 4060が7割以上速く、レイトレーシングを最大にすると差は1割を切ります。
Steam snapはCanonicalがベストエフォートで提供しているもので、Valveのサポート対象ではありません。重いゲームで音が途切れる、Wayland環境のCounter-Strike 2で視点が動かなくなるといった不具合と回避策も、Canonicalのテスト告知に追記されています。
DGX SparkのOSはNVIDIAが用意するDGX OSで、Windowsは用意されていません。
Armのチップで、Windowsのゲームをそのまま遊びたいなら、Windows 11で動くRTX Spark搭載ノートPCのほうが向いています。違いはNVIDIA RTX Sparkの解説にまとめています。
使い方DGX Sparkはゲーミングの代わりではなく隣に置くAIサーバー
NVIDIAが64GB版の発表で挙げた3つの使い方は、どれもDGX Sparkを普段のPCとは別に動かす前提です。
ゲーマーにとっての利点は、ゲーミングPCのGPUをゲームに専念させられることです。RTX 5090でLLMを動かしたままゲームを起動すると、VRAMとGPUの処理をゲームと取り合います。AIをDGX Sparkに任せれば、ゲーム側は32GBのVRAMをまるごと使えます。
考え方は、データだけをPCから切り離して置くNASに近いものです。電源は外付けの240Wアダプターに収まるので、カードだけで575WのRTX 5090を積んだPCでAIを回し続けるより、常に動かしておく置き方に合っています。
他社比較AMDとAppleも大容量の共有メモリ機を出している
CPUとGPUで大きなメモリを共有し、32GBを超えるモデルを1台に載せる考え方は、DGX Sparkだけのものではありません。3社の違いは、CUDAが使えるかどうかと、メモリの速さです。
| 製品 | メモリと帯域 | 価格とソフト |
|---|---|---|
| NVIDIA DGX Spark | 64GB・128GB、273GB/s | 64GB版4,999ドル〜(米国)。CUDA対応、OSはDGX OS |
| AMD Ryzen AI Halo Ryzen AI Max+ 395 | 128GB(GPUに最大96GB)、256GB/s | 3,999ドル(米国)。CUDA非対応、WindowsとLinux |
| Apple Mac Studio M5 Ultra | 96GB・256GB(512GBは10月後半)、1.2TB/s | 949,800円〜。CUDA非対応、macOS |
AMDのRyzen AI Max+ 395は最大128GBのLPDDR5Xを積み、そのうち最大96GBをGPU用に割り当てられます。AMDはこのチップと128GBを積む開発者向けミニPC「Ryzen AI Halo」を米国で3,999ドルで販売していて、最大2,000億パラメータのモデルを動かせるとしています。
Ryzen AI Max+ 395の機械はx86のWindowsが動くので、ゲームはそのまま遊べます。CUDAは使えませんが、このチップを積むミニPCは国内でも各社から出ていて、DGX Sparkより安く128GBをそろえられます。
AppleのMac Studioは8月にM5 Ultraへ世代が変わり、メモリは96GBから選べます。10月後半には512GBの構成が加わる予定です。メモリ帯域は1.2TB/sで、DGX Sparkの4倍以上あります。CUDAは使えず、Windows向けのゲームもそのままでは動きませんが、大きなモデルを置いたときの生成の速さを決める帯域では、3つの中でいちばん速いメモリです。
価格家庭用AIマシンと呼ぶにはまだ高い
DGX Spark 64GBの4,999ドルは、1年前に128GB版が発売されたときの3,999ドルより1,000ドル高い値段です。128GB版はその後も値上げが続き、NVIDIAが売るFounders Editionは6,950ドルになりました。64GB版は、値上がりした128GB版より安い入り口という位置づけです。価格の経緯はDGX Sparkの価格上昇の記事で追っています。
AIのためだけに5,000ドル前後を払って元が取れるのは、開発や業務で毎日使う人です。ローカルLLMを試してみたい段階なら、手持ちのGeForceで7B〜30Bクラスのモデルを動かすところから始めるほうが現実的です。VRAMごとに動くモデルの目安はAI画像生成・ローカルLLM用PC構成ガイドで、ミニPCで動くモデルの目安はLM Studio Bionicの必要スペックで確かめられます。
CUDAにこだわらなければ、64GB〜128GBの共有メモリを持つ機械はすでにもっと安く買えます。国内で買えるRyzen AI Max+搭載ミニPCはRyzen AI Max+搭載ミニPCの比較で並べています。家庭用のAIマシンが広がるかどうかは、CUDAが使える機械がこの価格帯まで下りてくるかにかかっています。
選び方使い方別に選ぶならこの4通り
RTX 5090のゲーミングPCは、ゲームと32GBまでのAIを1台でこなす構成です。AI専用機を横に置くなら、CUDAが要らない場合はRyzen AI Max+ 395の128GBミニPCが候補になります。


※価格・在庫・構成は変動します。最新情報は各商品ページでご確認ください。
展望ゲーミングPCとAI用のPCは分かれていくか
これまでの高性能PCは、CPUとGPUを速くして、ゲームも動画編集もAIも1台でこなす考え方でした。ローカルAIでは、この前提が当てはまらない場面が出てきています。
ゲームが求めるのは速いGPUと速いVRAMで、容量は32GBあれば十分です。一方で大きなLLMは、速さより先に、モデル全体を置ける容量を求めます。RTX 5090とDGX Sparkの差は、この2つの要求の違いをそのまま表しています。
NVIDIAは64GB版を出した理由に、性能の高いオープンモデルが小さくなり、より多くの機器で動くようになったことを挙げています。モデルが小さくなるほどゲーミングPCのGPUで動く範囲は広がり、AI専用機が要る人は減ります。逆に、エージェントを常に動かしておく使い方が広がれば、ゲーム用とは別にAI用の機械を置く人は増えます。
当面は、クラウドのAIだけを使う人、ゲーミングPCのGPUでローカルAIも動かす人、AI専用機を別に置く人の3通りに分かれていきそうです。DGX Spark 64GBは3つ目を具体的な製品にしたものですが、価格を見るかぎり、まだ開発者や業務で使う人のための機械です。
FAQよくある質問
まとめまとめ|DGX Sparkはゲーミングの代わりではなく横に置くAI専用機
DGX Spark 64GBは、128GB版と同じGB10を積み、メモリを半分にした4,999ドルのモデルです。10月23日にAcer、ASUS、Dell、GIGABYTE、HP、MSIから発売されます。
32GBに収まるモデルなら、ローカルLLMの生成はRTX 5090が4〜6倍速く、ゲームもArm版Steamの非公式対応でRTX 4060を下回ります。DGX Sparkが勝つのは、70Bクラスや1,000億パラメータまでのMoEモデルのように、32GBを超えるモデルを動かすときです。
ゲームとAIを1台で済ませるなら、GeForce搭載のゲーミングPCで十分です。32GBを超えるモデルやAIエージェントをCUDAで常に動かしたい人だけが、ゲーミングPCの横にDGX Sparkを置く意味があります。CUDAが要らなければ、Ryzen AI Max+ 395の128GB機のほうが安く大容量をそろえられます。
出典:NVIDIA公式ブログ「NVIDIA DGX Spark 64GB Gives Developers More Ways to Build and Scale Local AI」、NVIDIA DGX Spark User Guide「Hardware Overview」、NVIDIA GeForceグラフィックスカード比較、LMSYS「NVIDIA DGX Spark In-Depth Review」(計測データの表を含む)、llama.cpp「DGX Spark」ベンチマーク、Ubuntu Discourse「Call for testing: Steam snap for arm64」、Ubuntu Discourse「Canonical’s Steam Snap is now stable on Arm64」、NVIDIA Developer Forums「Beta of Steam snap for arm64」、AMD Ryzen AI Halo製品ページ、Apple ニュースリリース「M5 MaxとM5 Ultraを搭載した新しいMac Studio」
あわせて読みたい