RadeonはローカルAI用GPUとして買い?ROCm 10.1でWindows対応拡大、GeForceとの差を検証【2026年10月】
本記事にはアフィリエイト広告(Amazon・楽天市場等)のリンクが含まれています。
ROCm 10.1でWindows対応は広がったが、決め手はVRAMと使うツール
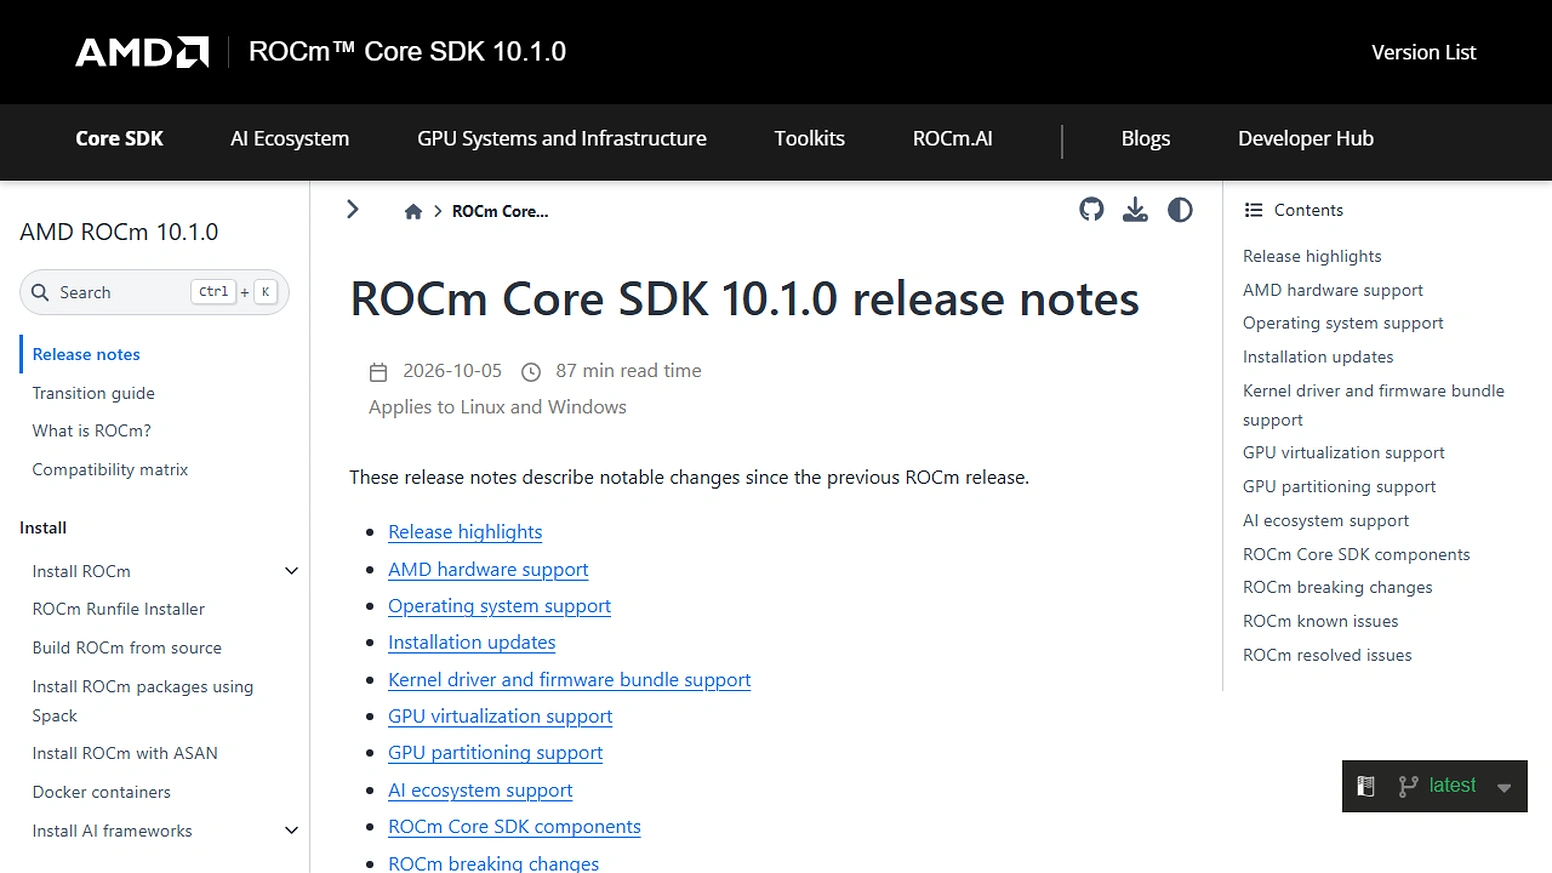
AMDは2026年10月5日付でROCm 10.1と、Radeon向けの専用ドライバー「AMD Software: Adrenalin Edition for ROCm 10.1」(26.10.41.05)を公開しました。RX 9000・RX 7000シリーズでWindowsのAIを動かす環境は、大きく広がっています。「AI用のGPUももうRadeonでいいのでは」と考えるのは自然です。
答えは「手持ちのRadeonなら試す価値大、AIが主目的の新規購入なら使うツール次第」です。OllamaでGGUF形式のモデルを動かすだけなら、ROCmがなくてもVulkanでRadeonは使えます。一方、WindowsでROCmの公式対応に載っているAIフレームワークはPyTorchで、vLLMやSGLangなどはLinux向けです。
ローカルLLMで最初にぶつかる壁は演算性能ではなく、モデルがVRAMに収まるかどうかです。16GBのRX 9070 XTと24GBのRX 7900 XTXでは、載せられるモデルの上限が変わります。
目次
結論先に結論|Radeonで足りる人とGeForceが無難な人
- すでにRX 9000・RX 7000を持っていて、OllamaやllamaでローカルLLMを試したい人
- ゲームが主役で、AIは7B〜14B級のモデルを動かす程度の人(RX 9070 XTの16GBで収まる範囲)
- Windows 11 25H2でPyTorchを使い、AMDの対応表どおりの環境を作れる人
- 24GBのVRAMを重視し、20〜30B級のモデルを載せたい人(RX 7900 XTX)
- GitHubで見つけたAIプロジェクトを、環境構築で悩まずそのまま動かしたい人
- vLLM・SGLang・JAX・TensorFlowなどを使う予定で、Linuxへの切り替えを避けたい人
- AIが主目的のPCを新しく買う人(Radeonの対応表に合わせて選ぶ手間をかけたくない場合)
ROCm 10.1Windowsで正式に載ったのはPyTorch、vLLMとSGLangはLinuxのまま
ROCmはAMDのGPUコンピューティング基盤で、NVIDIAのCUDAに近い役割を持ちます。10.1ではWindows 11上のPyTorch 2.14.0(Python 3.11〜3.14)が対応表に入り、Radeon向けのWindows構成としてWindows 11 25H2とAdrenalin 26.10.41.05が記載されました。
| AI環境(ROCm 10.1) | Windows | Linux |
|---|---|---|
| PyTorch 2.14.0 | 対応(Python 3.11〜3.14) | 対応 |
| JAX 0.11.1 | 対応表はLinuxのみ | 対応 |
| vLLM 0.29.0 | 対応表はLinuxのみ | 対応 |
| SGLang 0.5.18 | 対応表はLinuxのみ | 対応 |
| TensorFlow 2.21 | 対応表はLinuxのみ | 対応 |
| ONNX Runtime 1.29.0 | 対応表はLinuxのみ | 対応 |
※AMD公式のROCm 10.1互換表より。HIP、hipBLAS、MIOpenなどの計算ライブラリにはWindows対応がありますが、ツールごとのOSは各ツールの行で確認します。
専用ドライバー26.10.41.05の対応OSはWindows 11 21H2以降とWindows 10 64bit 1809以降です。一方、ROCm 10.1の互換表がRadeon向けに載せているWindowsは11 25H2だけです。ROCm目的で環境を作るなら11 25H2に合わせます。経緯はROCm 10.1専用Adrenalinの解説にまとめています。
vLLMのようにAPIサーバーとして使うツールをWindows PCで試したいときは、WSL2が選択肢になります。ROCm 10.1ではTheRockの配布物にWSL2対応が加わりました。ただしAMD自身がTechnical Previewと位置づけていて、対象はUbuntuのdebパッケージとPythonのwheelです。プロファイリングやGPUデバッグ、KFDに依存するツールは使えません。
OllamaRX 9000はWindowsのROCm一覧にないが、Vulkanで動かせる
ローカルLLMの入口として使われるOllamaの公式ドキュメントを見ると、WindowsでROCm経由のAMD GPUとして載っているのはRX 7000シリーズです。RX 9000シリーズはLinuxの一覧にだけあります。
| GPU | WindowsのROCm | LinuxのROCm |
|---|---|---|
| RX 9070 XT・RX 9070 | 一覧になし | 一覧にあり |
| RX 9060 XT | 一覧になし | 一覧にあり |
| RX 7900 XTX・7900 XT | 一覧にあり | 一覧にあり |
| RX 7800 XT・7700 XT | 一覧にあり | 一覧にあり |
| RX 6800 XT・6900 XT | 一覧になし | 一覧にあり |
※Ollama公式ドキュメントのGPU対応表。Windowsは「ROCm v7/HIP7に対応したドライバー環境が必要」とされています。
ただし、この表だけでRadeonを外す必要はありません。OllamaにはVulkanバックエンドがあり、WindowsとLinuxの両方で追加のGPUを使えます。バックエンドが入っていれば標準で有効になり、Windowsでは多くのGPUドライバーにVulkanが含まれています。
RX 9070 XTでOllamaを使うだけなら、ROCm 10.1専用ドライバーを入れることが前提条件にはなりません。ゲーム用の通常のAdrenalinのままで、Vulkan経由でGPUを使える構成です。
速度ROCmがVulkanより速いとは限らない|測定で結果が割れる
llama.cpp公式リポジトリのDiscussionには、ROCmとVulkanを同じGPUで比べた投稿があります。RX 9070 XT(Linux、Mesa RADV 26.1.4、ROCm 7.1.1、llama.cpp b10034)では、文章の生成速度(tg128)はVulkanが上でした。
| 測定条件(生成速度・毎秒トークン) | Vulkan | ROCm |
|---|---|---|
| RX 9070 XT、Llama 2 7B Q4_0、Flash Attention有効、Fedora 44 | 約132 | 約122 |
| RX 9070 XT、Llama 3.2 3B Q4_K_M、Flash Attention有効、Fedora 44 | 約220 | 約179 |
| RX 7800 XT、Llama 2 7B Q4_0、Flash Attention無効、Windows 10 2025年のビルド | 96.9 | 100.9 |
| RX 7800 XT、Llama 2 7B Q4_0、Flash Attention有効、Windows 10 2025年のビルド | 96.0 | 96.0 |
※いずれも利用者がllama.cppのDiscussionに投稿した値で、AMDの公式ベンチマークではありません。GPU・OS・ビルドが異なるため、行をまたいだ比較はできません。ROCm 10.1での測定でもありません。
Linuxの9070 XTではVulkanが7B Q4_0で約8%、3Bで約23%上回りました。Windows上の7800 XTでは、Flash Attention無効ならROCmがわずかに上、有効なら同等です。つまり、どちらかが常に速いとは言えず、GPU・OS・ビルド・設定で順位が入れ替わります。
7B Q4_0のモデルは約3.8GBです。9070 XTのメモリ帯域は最大640GB/sなので、毎トークンにモデルを1回読む前提の上限は約167トークン/秒になります。上のVulkanの約132は上限の約8割、ROCmの約122は約7割です。生成速度はメモリ帯域に強く縛られるため、帯域の広いGPUほど有利になります。
内蔵GPUのRadeon 680MでもVulkan版のllama.cppなら、MoEモデルで毎秒20トークンを超えました。実測はGMKtec M7 Proの実機レビューにあります。GGUFのモデルを動かすだけなら、「ROCmの対応GPUか」だけでGPUを選ぶ時代ではなくなっています。
用途ROCm 10.1が効くのはPyTorchで学習・開発する人
ROCmの価値が大きいのは、PyTorchやHIPを直接使う人です。モデルの学習、ファインチューニング、独自アプリへのGPU処理の組み込みでは、GGUFをVulkanで動かすだけでは足りません。
10.1の解決済み問題には、RX 9070シリーズやRadeon AI PRO R9700でLlama-FactoryやUnslothを使った学習中にGPUリセット・クラッシュが起きる問題が載っています。この修正はWindows専用とは書かれていません。手元のRX 9070系で学習が不安定だった人は、10.1への移行を試す価値があります。
RX 6000シリーズは注意が必要です。ROCm 10.1のRadeon向け互換表には、RX 9000(gfx1201・gfx1200)、RX 7000(gfx1100〜gfx1102)、RDNA 2のRadeon PRO W6000(gfx1030)が載っていて、コンシューマー向けのRX 6000は載っていません。ローカルLLMだけなら、OllamaのLinux一覧にRX 6950 XT・6900 XT・6800 XTなどがあり、Vulkanでも使えます。ROCm 10.1の公式対応を期待して買い替える理由にはなりません。
VRAM16GBのRX 9070 XTと24GBのRX 7900 XTX、載るモデルが変わる
| 項目 | RX 9070 XT | RX 7900 XTX |
|---|---|---|
| アーキテクチャ | RDNA 4 | RDNA 3 |
| VRAM | 16GB GDDR6 | 24GB GDDR6 |
| メモリ帯域 | 最大640GB/s(256bit) | 最大960GB/s(384bit) |
| 標準ボード電力 | 304W | 355W |
| 推奨電源 | 750W以上 | 800W以上 |
| WindowsのOllama(ROCm) | 一覧になし(Vulkanは可) | 一覧にあり |
※AMD公式の製品仕様とOllama公式ドキュメントより。RTX 5070 Tiも16GB(GDDR7)で、VRAM容量はRX 9070 XTと同じです。
ローカルLLMではモデルの重みに加えて、会話の長さに応じて増えるKVキャッシュと、Windowsの画面表示にもVRAMが使われます。以下はモデルファイルの大きさから見た目安です。
| モデル(量子化・ファイルサイズ) | 16GB | 24GB |
|---|---|---|
| Qwen3-8B(Q4_K_M・5.0GB) | 余裕あり | 余裕あり |
| Qwen3-14B(Q4_K_M・9.0GB) | 収まる | 余裕あり |
| gpt-oss-20b(MXFP4・12.1GB) | 収まる(長い文脈は余裕が少ない) | 余裕あり |
| Gemma 4 26B-A4B(Q4_0・14.6GB) | ぎりぎり | 収まる |
| Qwen3-30B-A3B 標準の4ビット・18.6GB | 載らない | 収まる(約5GBの余裕) |
※ファイルサイズは、Radeon 680M搭載ミニPCの実測で使ったモデルのもの。16GB・24GBの列は、サイズにKVキャッシュと表示用VRAMを加えた目安で、実測ではありません。
この表のとおり、16GBでは20B級までが現実的な範囲で、30B級の標準的な4ビット版はVRAMからあふれます。あふれた分はCPU側メモリにオフロードされて、速度が大きく落ちます。24GBのRX 7900 XTXは、世代が古くてもこの壁を越えられる点が強みです。
帯域でも、RX 7900 XTXは最大960GB/sです。同じ7B Q4_0で計算した上限は約251トークン/秒で、RX 9070 XTの約167より高くなります。24GBのRX 7900 XTXについては2026年でも現役かを検証した記事で、ゲーム面と電源・発熱も扱っています。
比較RadeonとGeForceの比較|用途別にどちらを選ぶか
| 用途 | Radeonの状況(10.1・Vulkan) | 選び方 |
|---|---|---|
| Ollamaでチャット・要約 | Vulkanで動かせる。7000番台はWindowsのROCm一覧にも載る | 手持ちのRadeonでよい。新規購入はVRAM容量で選ぶ |
| PyTorchで学習・開発 | Windows 11 25H2でPyTorch 2.14が対応。RX 9070系の学習クラッシュは10.1で修正 | AMDの対応表どおりの環境を作れるならRadeonで足りる |
| vLLM・SGLang・JAXなど | ROCm 10.1の対応OSはLinux。WSL2はTechnical Preview | Linuxで使う前提。RadeonはROCm、GeForceはCUDAの対応を各ツールで確認する |
| ゲームが主役でAIは試す程度 | RX 9070 XTの16GBは7B〜20B級まで | ゲーム性能と価格でRX 9070 XTかRTX 5070 Tiを選べる |
ツールがCUDA前提で作られている場合は、Radeonでそのまま動かせるとは限りません。使うツールのGitHubやドキュメントで、ROCmやVulkanへの対応を先に調べてください。調べる時間をかけられないAI用途では、GeForceのほうが外れを引きにくい選択です。
ゲーム性能の比較はRTX 5070 TiとRX 9070 XTの19ゲーム検証、Stable Diffusionまで含めた構成はAI画像生成・ローカルLLM用PC構成ガイドが参考になります。
おすすめ目的別に選ぶGPU
ゲームが主役でAIは試す程度ならRX 9070 XT、モデルを大きく載せたいなら24GBのRX 7900 XTX、CUDA前提のツールまで試すならRTX 5070 Tiです。いずれも価格は日々動くため、購入前に各ページで確かめてください。


※価格・在庫は変動します。最新の価格はAmazonの商品ページでご確認ください。
FAQよくある質問
まとめまとめ|Radeonは「諦める」から「用途で選べる」へ
ROCm 10.1で、WindowsのPyTorch 2.14が正式対応に入り、WSL2もTechnical Previewで使えるようになりました。一方で、vLLM・SGLang・JAX・TensorFlowの対応OSはLinuxです。OllamaでGGUFを動かすだけなら、ROCmよりVulkanのほうが簡単で、測定によってはVulkanのほうが速い結果も出ています。
ゲーム中心ならRX 9070 XT、モデルを大きく載せたいなら24GBのRX 7900 XTX、AI開発の互換性を優先するならGeForce。この順で、使うツールの対応表を確かめてから選んでください。
出典:ROCm 10.1専用Adrenalinのリリースノート / ROCm互換表 / ROCm 10.1リリースノート / Ollama GPU対応表 / llama.cpp Discussion #15021 / Radeon RX 9070 XT仕様 / Radeon RX 7900 XTX仕様 / GeForce RTX 5070ファミリー仕様(いずれも2026年10月8日に確認)
あわせて読みたい



Amazonの価格・在庫情報について



Amazonの価格・在庫情報について