Nemotron 3.5 Transcribeの必要VRAM|日本語対応の無償文字起こしAI、手持ちのGeForceで動くか【2026年11月】
本記事にはアフィリエイト広告(Amazon・楽天市場等)のリンクが含まれています。
公式の設定表は8GBから。16GB以下は専門家層をメインメモリへ逃がし最長29分
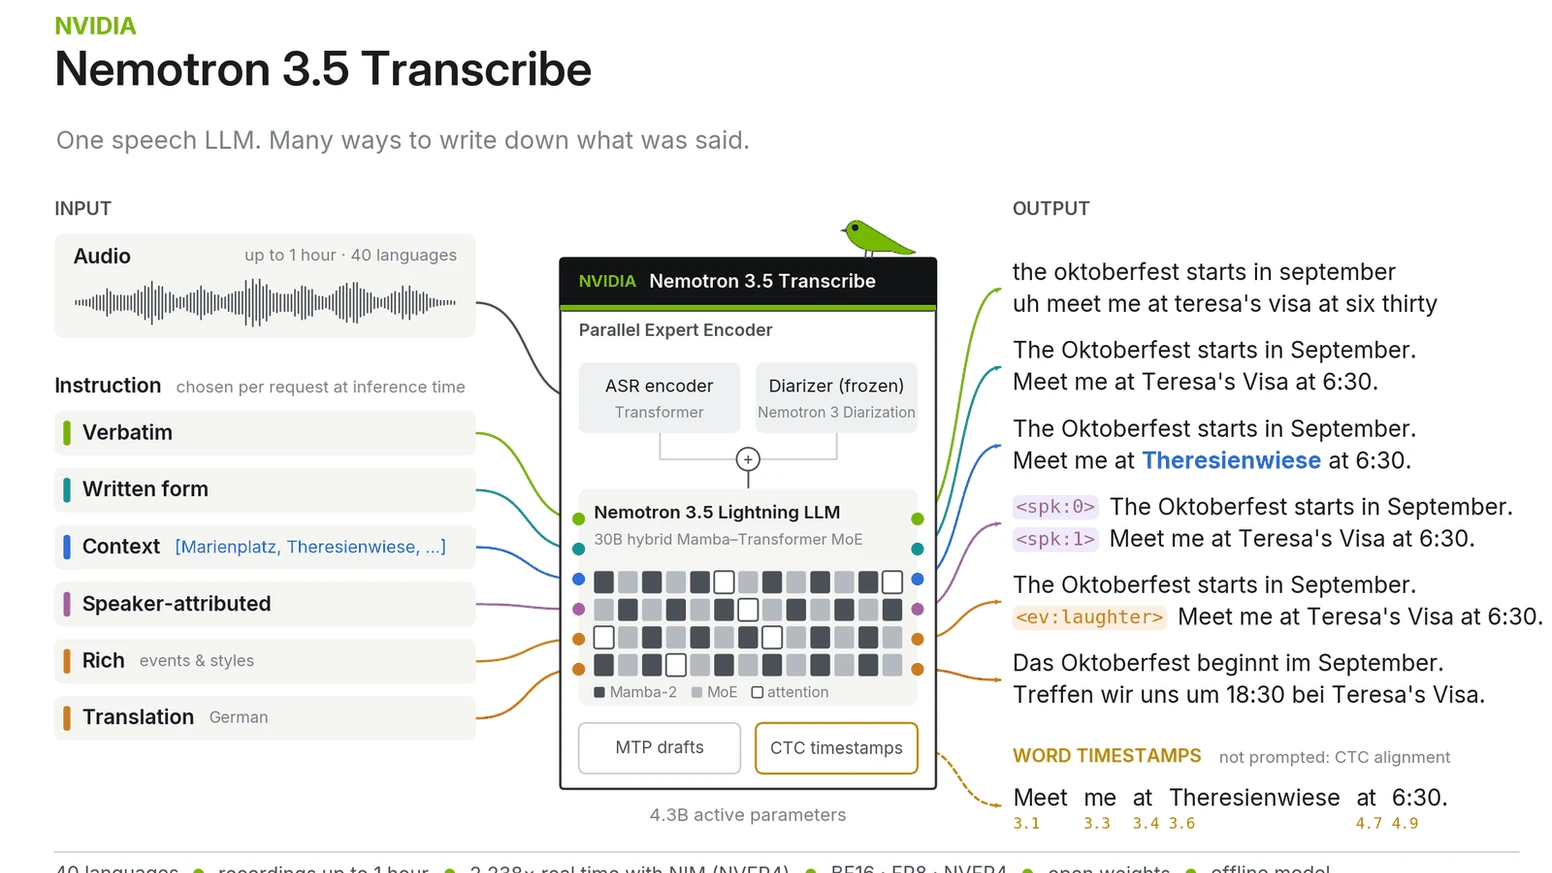
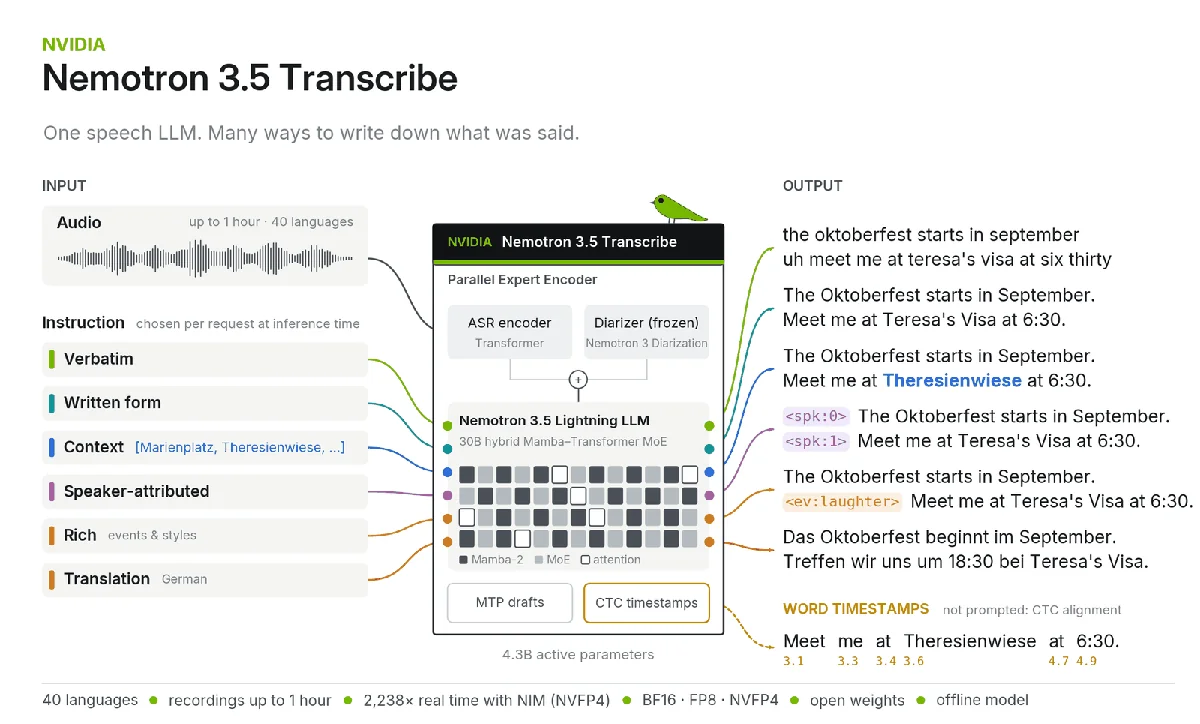
NVIDIAが2026年10月28日に公開した「Nemotron 3.5 Transcribe」は、40言語の文字起こしに対応するオープンウェイトのAIです。録音は最大1時間まで扱え、日本語の文字起こし、英語との相互翻訳、話者ごとの文字起こしにも対応します。気になるのは、手持ちのGeForceで動くかどうかです。
公式の対応表に載るGeForceはRTX 5090(32GB)で、NVFP4版を使います。24GBのカードには、GGML版(NeMo-Speech.cpp)の設定例があり、Blackwell世代以外ではIQ4_NLという形式に変換して使います。公式の設定表には8GB・12GB・16GBの行もあり、IQ4_NLの重みの一部をメインメモリに置いて動かします。24GB以下の設定では、録音は最長29分までです。
文字起こしだけを手元で済ませたいなら、WhisperのturboやlargeならVRAM約6〜10GBで足ります。Nemotronを選ぶ理由は、話者ラベル、単語ごとの時刻、翻訳、指示つきの書き起こしまで1つのモデルで扱えることです。導入はLinux向けの手順が中心で、手間は小さくありません。
目次
必要VRAM精度ごとの容量と、公式の対応GPU
GPUの空きメモリは、重みの容量に加えて、実行中のキャッシュや作業領域でさらに増えます。次の容量は重みファイルの合計で、必要VRAMそのものではありません。
| 精度 | 重みの容量 | 公式の対応表に載るGPU |
|---|---|---|
| BF16(元のモデル) | 67.5GB | H100・H200・A100 80GB・B200など |
| FP8 | 34.7GB | L40S 48GB・H100・H200・RTX PRO 6000 Blackwellなど |
| NVFP4 | 21.6GB | RTX 5090・RTX PRO 6000 Blackwell・DGX Sparkなど |
※容量はHugging Face上の各リポジトリのファイル合計(2026年11月1日確認)。対応GPUはNVFP4版モデルカードのHardware Compatibility表より。NVFP4版はBlackwell世代のGPUが必須で、公式のvLLM起動例は96GBのRTX PRO 6000 Blackwellです。
総パラメーター数は約34B、推論時に動く部分は約4.3Bです。動く部分が小さくても、NVFP4版などをGPUで動かすときは重みの全体を載せるため、動く部分の数字から必要VRAMは割り出せません。
GeForce別手持ちのGeForceで動くか
| 手持ちのGPU | 公式資料での扱い | 現実的な選択 |
|---|---|---|
| RTX 5090(32GB) | vLLMの対応表にNVFP4で掲載。GGML版の既定設定も32GB向けで、1時間の録音まで扱える | NVFP4版を公式手順で導入する |
| 24GBのカード | GGML版に24GB用の設定例がある。IQ4_NLの重みで、録音は最長29分、同時処理は4件、推測デコードは無効 | 自分で変換して導入する。公式の設定では29分まで。長い会議は分ける |
| 16GBのカード | GGML版に16GB用の設定例がある。IQ4_NLの重みでn_cpu_moe: 28、同時処理は1件、録音は最長29分。Q2_0に変換すればGPUに全部載る(誤り率は相対で約4%悪化) | IQ4_NLで1件ずつ処理するか、速度を取るならQ2_0を使う |
| 8GB・12GBのカード | GGML版に設定例がある。IQ4_NLの重みでn_cpu_moeは8GBが53(専門家層をすべてメインメモリへ)、12GBが40。同時処理は1件、録音は最長29分 | メインメモリに余裕を持たせて1件ずつ処理する。処理速度は落ちる |
※GGML版の設定はNVIDIA公式のNeMo-Speech.cpp(SALMのGPUメモリ表)より。計算能力8.0以上のNVIDIA GPU(RTX 30シリーズ以降)が対象で、CUDA 12.8以上が必要です。16GB以下の設定は、MoEの専門家層の一部(8GBではすべて)をメインメモリに置くn_cpu_moeを使います。GPUだけで処理するより遅くなるため、公式資料では同時処理を1件にする設定と組み合わせています。
FP8版は重みが34.7GBなので、24GBや32GBのGeForceには載りません。公式の対応表でFP8に載るのは、L40Sなど48GB以上のデータセンター向けGPUです。
導入Windowsで動かすときの準備
導入の経路は2つあります。vLLMの経路はLinux向けで、Windowsでは「WSL2経由」になります。GGML版はネイティブWindowsにも対応し、PowerShellからインストールできます。vLLMの公式手順で必要なものは次のとおりです。
- Blackwell世代のGPU(NVFP4版)。GeForceならRTX 50シリーズ
- vLLM 0.32.0と、対応するNeMo Speechの最新main。Pythonは3.13の例
- CUDA 13のnvcc。初回起動でカーネルをコンパイルするため、起動に数分かかる
- Hugging Faceから重みをダウンロード(NVFP4版は21.6GB)
git clone https://github.com/NVIDIA-NeMo/Speech.git nemo-speech
cd nemo-speech
uv venv --python 3.13 .venv
UV_PROJECT_ENVIRONMENT=$PWD/.venv uv sync --extra asr --extra vllm --locked --no-install-project
uv pip install --python .venv/bin/python --no-deps -e .
uv pip install --python .venv/bin/python --no-deps av==19.0.2
uv pip install --python .venv/bin/python --no-deps opencv-python-headless==5.0.0.93
source .venv/bin/activate
hf download nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B-NVFP4 --local-dir ./NVIDIA-Nemotron-3.5-Transcribe-30B-A4B-NVFP4起動はvllm serveで行い、127.0.0.1:8000のOpenAI互換APIに音声とプロンプトを送ります。起動オプションの全文は、NVIDIAのモデルカードにある例をそのまま使います。例は96GBのGPUで検証されたもので、--gpu-memory-utilizationなどの値を32GBのGeForceにそのまま当てはめられるかは、公式からは分かりません。
24GBのカードで使うGGML版は、公式の手順では、BF16の重み(67.5GB)をダウンロードし、convert_model.pyでGGUFに変換します。Blackwell世代はnvfp4、それ以外のNVIDIA GPUやCPU、Vulkanはiq4_nlを指定します。
hf download nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B --local-dir checkpoints/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
python3 convert_model.py checkpoints/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B --architecture salm \
--outtype iq4_nl --outfile models/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B-IQ4_NL.gguf24GB用の設定はmax_sequences: 4、max_context: 32768、mtp_draft: 0、n_batch: 1024、encoder_max_batch: 4です。変換すると、デコーダと、全精度で共有するエンコーダ(-Encoder-F16.gguf)の2つのGGUFができます。両方を同じフォルダに置き、デコーダのパスを指定して起動します。変換後の容量は、公式資料に載っていません。
密な会話の1時間分は、出力が約20,000トークンになることがあります。vLLMの公式の例ではmax_tokensが16,384なので、長い録音では引き上げるか外さないと、文字起こしが途中で切れます。
比較Whisperとの違いと使い分け
| 項目 | Nemotron 3.5 Transcribe | Whisper(turbo・large) |
|---|---|---|
| VRAMの目安 | 重み21.6GB(NVFP4)。GGML版の公式設定表は8GBから(16GB以下はメインメモリを併用) | turbo約6GB、large約10GB(公式README) |
| 主な機能 | 文字起こし、英語との相互翻訳、話者ラベル、単語ごとの時刻、指示つきの書き起こし | 文字起こしと翻訳。turboは翻訳に非対応(公式README) |
| 主な動作環境 | Linux・WSL2・GGML(ネイティブWindows) | Pythonのパッケージとして導入するコマンドライン/ライブラリ |
※Whisperの数値と機能はOpenAI公式READMEの表記。日本語の精度を同じ条件で比べた結果は、現時点で確認できていません。
文字起こしだけで導入の手間を抑えたいなら、Whisperは手軽です。話者を分けた議事録や、単語ごとの時刻、翻訳まで1つで済ませたい場合に、Nemotronの価値が出ます。16GB以下のカードでもNemotronは動かせますが、メインメモリを併用するぶん処理は遅くなります。
日本語日本語の精度とライセンス
日本語は公式の言語表で、文字起こし・英語との相互翻訳・複数話者・言語混在のすべてに対応し、品質区分は上から2番目の「Production-ready」です。BF16版の文字誤り率(CER)は、FLEURSで4.42%、CoVoST2で10.61%と公表されています。NVIDIA自身の評価で、一般的な会議録音の精度を示す数字ではありません。
NVFP4版は、書き起こしの評価全体の平均で、BF16版より誤り率が相対で3.6%高くなります。この数字は書き起こしのベンチマーク全体の平均で、日本語だけの劣化率は公表されていません。
ライセンスはOpenMDW-1.1で、無償で使え、出力した文字起こしの利用にも制限はありません。モデルを再配布するときは、ライセンス全文と出所の表示を残す必要があります。
結論向いている人・向かない人
- 話者ラベルや単語の時刻、翻訳まで1つのモデルで済ませたい
- 商用でも使える無償モデルを探している
- LinuxやWSL2、変換コマンドの操作に抵抗がない
- VRAM 16GB以下のカードで、長い録音をまとめて速く処理したい(公式の設定は1件ずつ・最長29分)
- 24GB以下のカードで1時間の録音を一度に処理したい(公式の24GB以下の設定は29分まで)
- 数分の音声を気軽に文字起こししたいだけ
おすすめ用途に合うGeForce
Nemotronを公式の対応表どおりに動かすなら、32GBのRTX 5090が前提です。16GBクラスのカードでも、公式の16GB用設定(IQ4_NLとメインメモリの併用)やQ2_0への変換で動かせます。速度より手軽さを取るならWhisperのlarge(約10GB)も収まり、ゲームとの兼用にも向きます。

FAQよくある質問
まとめまとめ|32GBなら公式手順、8〜24GBも設定例あり
Nemotron 3.5 Transcribeは日本語に対応した無償の文字起こしAIです。RTX 5090(32GB)は公式の対応表に載り、24GBのカードにはGGML版の設定例があります。8GB・12GB・16GBにも公式の設定があり、メインメモリを併用して録音は最長29分まで扱えます。速度と手軽さを優先するなら、VRAM約6〜10GBで動くWhisperも選択肢です。
出典:NVIDIA Nemotron 3.5 Transcribe(Hugging Face、BF16)、FP8版、NVFP4版、NVIDIA Research、NeMo-Speech.cpp(GPUメモリ設定)、NeMo-Speech.cpp(モデルと対応環境)、OpenMDW-1.1、OpenAI Whisper(いずれも2026年11月1日確認)
あわせて読みたい




Amazonの価格・在庫情報について


Amazonの価格・在庫情報について