画像1枚から3D化するAI「Idol」の必要VRAM|RTX 3080 10GBで動く?8GB GPUと生成時間【2026年11月】
本記事にはアフィリエイト広告(Amazon・楽天市場等)のリンクが含まれています。
ピークは7.2GB。RTX 3080(10GB)は1枚46.2秒
Speridlabsが2026年10月に公開した「Idol」は、物体の写真やレンダリング画像を1枚渡すと、写っていない裏側まで含む3Dオブジェクトを出力するオープンウェイトのAIです。重みとコードはHugging FaceとGitHubで無償公開されています。気になるのは、手元のGeForceで動くかどうかです。
モデルカードに載るVRAMのピークは7.2GBで、RTX 3080(10GB)は公式の速度表に載っています。1枚の生成にかかる時間は46.2秒で、RTX 4090(24GB)の19.1秒、RTX 5090(32GB)の14.1秒より長くなります。8GBのカードはピークとの差が約0.8GBしかなく、ほかのアプリがVRAMを使っていると足りなくなります。
出力は3Dガウシアンスプラットの.plyファイルで、ゲームのMOD用アセットとして使われるポリゴンメッシュではありません。ゲームに入れる用途では、変換の手間が別に発生します。商用で使うなら、推論時に読み込む2つの外部モデルのライセンスも確認が必要です。
目次
必要VRAMピーク7.2GBの内訳と、8GBカードの余白
モデルカードの記載では、1回の生成に必要なGPUメモリは、重みが約3.7〜4.4GB、ピークが7.2GBです。重みだけで見ると小さく、残りは生成中の作業領域です。
| 項目 | 公式の記載 | 手元のカードでの意味 |
|---|---|---|
| VRAMのピーク | 7.2GB | 10GB以上なら余裕があります。8GBは余白が約0.8GBです |
| 重みの合計 | 約3.7〜4.4GB(全体で約18億パラメーター) | 初回にIdol本体の重み約3GBに加え、DINOv3とFLUX.2のVAEも自動でダウンロードします |
| 最大の部品 | DINOv3(約1.68GB) | --dinov3_dtype fp32にすると1.7GB増えます |
| 動作環境 | Python 3.10以上、PyTorch 2.5以上、CUDA対応のNVIDIA GPU | Radeonは対象外です |
※Hugging Faceのモデルカードと、GitHubのidol-sdkのREADMEより(2026年11月2日確認)。7.2GBがどの生成枚数(--num_gaussians)の値かは記載がありません。
8GBのカードで試すなら、--dinov3_dtypeは既定のbf16のままにし、ブラウザや他のAIツールを閉じてから起動します。fp32にすると、7.2GBに1.7GBを単純に足して約8.9GBになり、8GBのカードでは載りません。10GBのカードならfp32でも収まる計算です。
GPU別RTX 3080は1枚46.2秒、RTX 5090は14.1秒
公式の速度表は、50ステップ・262,144個のガウシアンの条件で、8枚の画像の中央値を取っています。GPUごとにマシンを分け、コードと設定は同じです。
| GPU | VRAM | 1枚あたりの時間 |
|---|---|---|
| RTX 5090 | 32GB | 14.1秒 |
| RTX 4090 | 24GB | 19.1秒 |
| RTX 3080 | 10GB | 46.2秒 |
| H100(参考) | 80GB | 6.7秒 |
※Hugging Faceのモデルカード「Across GPUs」の表より(2026年11月2日確認)。RTX 3080は10GB版です。ほかのGeForceの行はありません。
モデルカードの冒頭には「2秒未満で動く」とありますが、速度表で最も速いB300でも50ステップで3.4秒です。GeForceでは14〜46秒が実際の目安になります。ステップ数(--steps、既定は50)を減らすと速くなる代わりに細部が落ちます。1枚ずつ試す使い方なら、RTX 3080でも待てない長さではありません。
同じプロセスで最初の1枚は、torch.compileによるコンパイルが入るため遅くなります。
導入Hugging Faceの承認から生成まで
導入前に、Hugging Faceのアカウントで2つの外部モデルの利用承認を済ませます。Idolは入力画像をこの2つで読み込むため、承認が済んでいないと、ダウンロードの前に不足を伝えて止まります。
- Hugging Faceにログインし、facebook/dinov3-vith16plus-pretrain-lvd1689mの利用条件に同意する
- black-forest-labs/FLUX.2-devの利用条件に同意する(使うのはVAEだけです)
- ターミナルで
hf auth loginを実行する(環境変数HF_TOKENでも可) - SDKをインストールして、画像から生成する
git clone https://github.com/speridlabs/idol-sdk.git
cd idol-sdk
pip install -e .

# 写真ならreal、レンダリングや生成画像ならsynthetic
python -m idol.sample --image photo.jpg --mode real1枚ごとに、3Dの本体である.ply、モデルが実際に見た入力画像(背景除去と切り抜き後)の_input.png、推定カメラの_camera.jsonが出力されます。.plyは一般的なガウシアンスプラットのビューアで開けます。重みはHugging Faceのキャッシュに自動で保存され、別のダウンロード手順はありません。
モデルカードとSDKのREADMEには、WindowsとLinuxのどちらで動かすかの記載がありません。LinuxかWSL2のUbuntuで試すほうが、CUDAとPyTorchの組み合わせを整えやすくなります。flash-attnは入れなくても動き、入れていない場合はPyTorch標準の注意機構が使われます(結果は同じで速度だけ遅くなります)。
| 主なオプション | 既定値 | 効果 |
|---|---|---|
| –steps | 50 | 減らすと速くなり、細部が落ちます |
| –num_gaussians | 262144 | 32,768〜1,048,576(32の倍数)。多いほど細かくなります |
| –seed | 42 | 固定すると同じ物体を再現できます |
| –mode | synthetic | 写真はreal。切り抜きの余白が変わります |
ライセンスApache 2.0でも、商用は外部モデルの条件が先
Idolの重みとコードはApache License 2.0で、商用利用が認められています。ただし推論には、DINOv3とFLUX.2 [dev]のVAEが必要で、この2つは別のライセンスです。
DINOv3はMetaの専用ライセンス(dinov3-license)、FLUX.2 [dev]はBlack Forest LabsのFLUX Non-Commercial Licenseです。FLUX.2のモデルカードには、生成物は商用を含む用途に使えるとの記載と、商用で自分のサーバーに置いて使う場合の別条件への言及があります。商用の案件に使うなら、2つのライセンス全文を読んでから決めてください。個人のゲーム制作や趣味の範囲で試す場合は、利用条件への同意だけで始められます。
ゲーム用途MODやゲームのアセットに使えるか
Idolが出力するのは、最大約105万個の「ガウシアン」(色と透明度を持つ小さな楕円体)の集まりです。見た目はフォトリアルに近づきますが、UnityやUnreal Engine、MODツールが標準で読むポリゴンメッシュとテクスチャではありません。
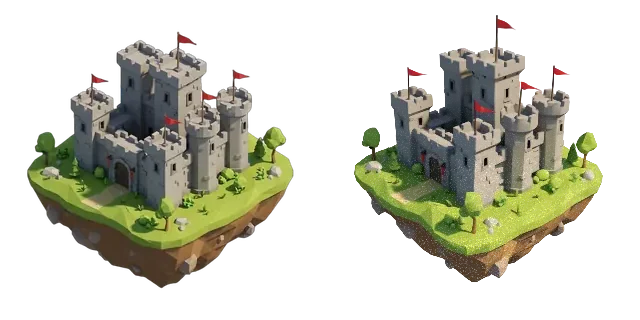
モデルカードに、メッシュへの変換手順はありません。ゲームの小物や背景の参考として回転しながら眺める、モデリングの下絵や形の確認に使う、といった用途なら、1枚の画像から短時間で形が得られる点が役に立ちます。ゲームに組み込めるアセットが必要な場合は、スプラットからメッシュへ変換する別のツールを足す前提で考えてください。
比較TRELLISなど、ほかの画像から3D化モデルとの違い
モデルカードには、TripoSplat、TRELLIS、LGMとの比較があります。条件はH100 1枚で、Speridlabs自身の測定です。
| モデル | 1枚の時間(H100) | 測定条件 |
|---|---|---|
| Idol | 6.8秒 | 50ステップ、262,144ガウシアン |
| TripoSplat | 9.9秒 | 50ステップ、262,144ガウシアン |
| TRELLIS | 7.1秒 | 論文の設定(50+50ステップ) |
| LGM | 1.1秒 | 既定設定、65,536ガウシアン |
※Hugging Faceのモデルカード「Benchmark」の表より。Idolは新しい視点の評価指標(DINOv2・CLIP)でも4モデルの中で最も高い値です。ただし比較は公開元自身の測定で、ほかのGPUでの結果ではありません。
LGMは最も速い一方、見た目はぼやけた結果になります。細部を取るならIdol、速さを優先するならLGMという位置づけです。
結論向いている人・向かない人
- VRAM 10GB以上のGeForceを持っていて、1枚数十秒の待ち時間は許容できる
- Python環境とHugging Faceの承認操作に抵抗がない
- ゲームの小物や背景の形を、写真から素早く確認したい
- Radeon・Intel Arcなど、NVIDIA以外のGPUしか持っていない
- MODやゲームにそのまま入れるメッシュが欲しい
- VRAM 8GB以下のカードで、他のアプリを開いたまま安定して動かしたい
おすすめローカルAIも使うなら12GB以上
手元が10GBのRTX 3080なら、Idolのために買い替える必要はありません。新しく買うなら、DINOv3をfp32にしても収まる12GB以上が安心です。ゲームと兼用するなら、16GBのカードのほうが他のローカルAIにも広げやすくなります。

FAQよくある質問
まとめまとめ|10GBならRTX 3080で動き、8GBは余白が薄い
Idolは、写真1枚から裏側まで含む3Dオブジェクトを作る無償のAIです。VRAMのピークは7.2GBで、RTX 3080(10GB)は1枚46.2秒、RTX 4090は19.1秒、RTX 5090は14.1秒です。8GBのカードは余白が約0.8GBで、動作例は公式にありません。
導入前に、DINOv3とFLUX.2 [dev]の利用承認をHugging Faceで済ませます。出力はゲームエンジン向けのメッシュではなくガウシアンスプラットで、商用では外部2モデルのライセンスも確認が必要です。
出典:Speridlabs Idol(Hugging Face)、idol-sdk(GitHub)、Meta DINOv3(Hugging Face)、FLUX.2 [dev](Hugging Face)、Apache License 2.0(idol-sdk)(いずれも2026年11月2日確認)
あわせて読みたい




Amazonの価格・在庫情報について




Amazonの価格・在庫情報について