ローカルLLMは何に使う?ChatGPTとの使い分け・API料金との比較と、グラボを買う前の判断基準【2026年10月】
本記事にはアフィリエイト広告(Amazon・楽天市場等)のリンクが含まれています。
ChatGPTとの使い分けと、グラボを買う前の判断基準
ChatGPTやClaudeで文章も調べ物もコードも済むのに、自分のPCでAIを動かす「ローカルLLM」のために高いグラボを買う人がいます。ローカルLLMとは、ChatGPTのようなAI(大規模言語モデル)のファイルを自分のPCに置き、PCの計算力で文章を作らせる使い方です。迷いどころは、その出費に見合う使い道が自分にあるのか、という点だと思います。
毎日の質問や文章づくりが中心なら、クラウドのAIで足ります。ローカルLLMが役に立つのは、外に出したくない書類を処理する、同じ形式の文章を大量に分類・要約する、自作のツールや24時間動かす自動処理にAIを組み込む、といった使い方です。どれも価値の中心はAIの賢さではなく、AIをどこで動かすかにあります。
グラボを買う前の判断は3段階です。まず今あるPCで小さなモデルを無料で試し、不満が速さなのか、扱えるモデルの大きさなのかを確かめます。用途がはっきりしていて、今のPCでは遅い、またはモデルが載らないと分かったときだけ、増設を考えます。費用の面では、クラウドAPIの単価が低い作業ほど、PCを買い足すより料金を払うほうが安く済みます。
目次
結論先に結論|まず手持ちのPCで試し、足りない点が分かってから増設する
- 顧客情報・契約書・未公開のコードなど、外部のサービスに送りたくない資料を扱う人
- 同じ形式の文章を毎日大量に分類・要約していて、API料金が気になる人
- 自作のツールや常時動かす自動処理にAIを組み込みたい人
- ゲーミングPCやミニPCをすでに持っていて、追加費用なしで試せる人
- 質問・調べ物・文章づくりが中心の人
- 難しいプログラミングや長い資料の分析で、できるだけ賢いモデルを使いたい人
- 最新ニュースの検索を含む質問が多い人
- AIを使うのが週に数回程度で、PCを買い足すほどではない人
グラボの買い足しは、試した結果をもとに決めれば遅くありません。高いグラボを買ってもクラウドの最上位モデルと同じ答えが得られるとは限らず、家庭用のPCに載るモデルは難しい作業で差が出ることがあります。
違いローカルLLMとクラウドAIの違いは、AIを動かす場所とデータの置き場所
クラウドAIは、サービス側のサーバーが文章を生成します。ローカルLLMは、モデルのファイルを自分のPCにダウンロードし、CPUやGPUで生成します。代表的な実行ソフトはLM StudioとOllamaで、LM Studioの料金ページとOllamaの料金ページでは、どちらもFreeプランにローカルでの実行が含まれています。
| 項目 | ChatGPT・Claudeなど | ローカルLLM |
|---|---|---|
| 文章を生成する場所 | サービス側のサーバー | 自分のPC・自宅のサーバー |
| 使えるモデル | 各社の高性能なモデル | 手元のPCに載る大きさのモデル |
| データの扱い | サービス・プラン・設定で異なる | 生成を自分のPC内で完結させられる |
| 料金 | 月額、またはAPIの従量課金 | ソフトは無料。PC代と電気代がかかる |
| ネット接続 | 基本的に必要 | モデルを入手したあとは不要(検索や更新は別) |
| 手間 | ほぼなし | 導入・更新・不具合の対応を自分で行う |
※LM StudioとOllamaの料金ページ、LM Studioのオフライン動作の説明をもとにした整理です(2026年10月26日に確認)。
LM Studioは、モデルの検索・ダウンロード、実行エンジンの取得、アプリの更新確認でネットに接続します。ダウンロード済みのモデルとのチャット、文書の読み込み、ローカルサーバーは接続なしで動きます(Offline Operation)。Ollamaにはクラウド上のモデルを使う機能もあるため、外に送りたくない作業では、ローカルのモデルを選ぶことに加えてクラウド機能を止めます。~/.ollama/server.jsonのdisable_ollama_cloudをtrueにするか、環境変数OLLAMA_NO_CLOUD=1を設定して再起動すると止められます(Ollama FAQ)。
用途ローカルLLMの使い道は6つ|ローカルが向く場面とクラウドで足りる場面
使い道が向くかどうかは、データを外に出せない、件数が多い、ほかのプログラムから呼び出したい、ネットが使えない、のどれかに当てはまるかで決まります。
| 用途 | ローカルが向く理由 | クラウドで足りる場面 |
|---|---|---|
| 外に出せない資料の処理 | 送信先を自分で決められる | 公開済みの情報や、学習に使わない設定で許容できる内容 |
| 手持ちの文書への質問(RAG) | 資料をPCの外に出さずに検索できる | 公開資料が中心で、機密性を気にしない場合 |
| 大量の分類・要約・抽出 | 件数が増えてもAPIの従量課金が増えない | 件数が少ない、または単価の低いAPIで済む場合 |
| 自作ツール・24時間の自動処理 | OpenAI互換のローカルAPIで呼び出せる | 実行回数が少なく、PCを常時動かす理由がない場合 |
| コードの一次分析 | 未公開のコードを外に出さずに確認できる | 複数のファイルにまたがる実装など、難しい作業 |
| ネットなしの利用・ゲームへの組み込み | 通信と月額なしで動く | 最新情報の検索を含む作業 |
外に出せない資料を処理する
クラウドAIがデータを学習に使うかどうかは、サービスとプランで異なります。ChatGPTのFree・Plus・Proの個人向けでは、会話をモデルの改善に使う設定が初期状態で有効で、設定画面からオフにできます。使える設定は、ログインの有無、プラン、ワークスペースの設定でも変わります(OpenAI Data controls)。個人向けのClaudeも、会話をモデルの改善に使うかどうかを利用者が選べる形です。法人向けとAPIには別の条件が定められています(Anthropic Privacy Center)。
ローカルLLMなら、文章の生成をすべて自分のPCの中で行えます。LM Studioでは、ダウンロード済みのモデルとのチャットで入力した内容は端末の外に出ません。Ollamaも、ローカルで実行するかぎりプロンプトやデータは見ないとFAQで明言しています。
ただし、ローカルで動かせば無条件に安全になるわけではありません。AIにファイル操作の権限を与えたり、ネットワークに公開したりすると、そこから情報が漏れる経路ができます。判断の目安は、社内の規則や契約で、その資料を外部のサービスへ送ってよいかどうかです。送れないなら、ローカルが有力な選択肢になります。
手持ちの文書に質問する(RAG)
PDFやマニュアルを読ませて質問する使い方は、LM Studioの文書チャットで試せます。文書が短くてモデルのコンテキストに収まるときは全文がそのまま渡され、非常に長いときは関連する部分だけを探して渡すRAG(検索拡張生成)に切り替わります(Chat with Documents)。RAGは、うまくいくこともあれば、調整や試行錯誤が必要なこともあります。
ここで効いてくるのがコンテキスト長、つまりモデルが一度に扱える文章量です。Ollamaの既定のコンテキスト長はVRAMで決まり、24GiB未満のGPUでは4kトークンです。エージェントやコーディングの用途では64,000トークン以上にするのが目安で、長くするほど必要なメモリも増えます(Ollama Context length)。長い資料を丸ごと読ませたい人ほど、モデルのサイズより先に、コンテキスト分のメモリが足りなくなりやすくなります。回答は、元の文書と照合して使ってください。
大量の文章を分類・要約する
費用対効果が出やすいのは、同じ形式の処理を繰り返す作業です。ニュースの見出しをジャンル別に振り分ける、問い合わせメールを種類別に仕分ける、ログから項目を取り出すといった作業は、毎回最高性能のAIを必要としない場合があり、小型のモデルで試す価値があります。件数が増えてもクラウドAPIのように従量課金は積み上がらず、PCが動いている間は何件でも処理できます。
次は、問い合わせメールの仕分けを想定した説明用のサンプルです。文章も結果も架空で、実際にモデルへ入力して得た出力ではありません。処理の形をつかむための例として見てください。
次の問い合わせ文を読み、JSONだけで答えてください。
categoryは「故障」「購入相談」「返品」「その他」のいずれか、
urgencyは「高」「中」「低」のいずれかにしてください。

問い合わせ文:
先週届いたPCが、ゲーム中に突然落ちます。保証期間内なので、修理の手順を教えてください。
{"category": "故障", "urgency": "中"}出力をJSONだけに絞ると、後ろのプログラムが結果を読み取りやすくなります。LM StudioのAPIにはJSONスキーマで出力の形を指定する機能があり、Ollamaにも構造化出力の機能があります。それでもモデルが形式を外すことはあるので、最初の数十件は人の目で確かめてください。
自作ツールや常時動かす処理に組み込む
LM StudioとOllamaは、手元のPCをAPIサーバーにできます。LM StudioはOpenAI互換のエンドポイントをローカルやネットワーク上で提供し、OllamaもOpenAI APIの一部に対応しています。OpenAIのAPIを呼ぶ形で作ったプログラムの接続先を、ローカルのモデルへ向けられる場合があります。対応しているのはAPIの一部なので、使う機能が含まれているかは公式の対応表で確かめてください。
24時間動かす自動処理では、AIが判断や文章生成をする部分だけをローカルに置けます。外のWebサイトを見に行く処理にはネット接続が必要で、ファイル操作、スケジュール実行、エラー処理は別に作り込みます。常時動かす機械をわざわざ置くべきかどうかは、Claude Codeに専用ミニPCは要るのかの電気代と実売価格の比較が参考になります。
コードの分析、ネットなしの利用、ゲームへの組み込み
コードの分析は、公開前のソースを外に出さずに確認したい場合に向きます。小さな関数の説明、エラーログの分類、テストデータの下書きのような補助作業が中心です。複数のファイルをまたぐ修正のように難しい作業は、クラウドの大きなモデルのほうが向いています。
ネットのない環境でも、モデルを入手済みなら文章づくりや要約を続けられます。最新ニュースの取得のように、ネットが前提の作業は別です。ゲームでは、AIの会話を自分のPCの中で生成する作品も出ています。『放置ピクセルメイド』は、AIの処理を自分のPCが受け持つため、ドット絵の作品としては高いRTX 3060(VRAM 8GB)が推奨GPUです。ゲームとAIが同じGPUのVRAMを使うので、ゲームを遊びながらローカルLLMも動かすと、どちらかが遅くなることがあります。
必要なPCグラボやメモリは「載るか」と「速いか」の2つで選ぶ
ローカルLLMでPCに求められるのは、モデルを置く容量と、文章を生成する速さです。容量は配布されているファイルの大きさから見当がつきます。
| モデルの規模 | Ollamaの配布サイズ | 収まりの目安 |
|---|---|---|
| Qwen3 4B | 2.5GB | VRAM 6〜8GBで余裕がある |
| Qwen3 8B | 5.2GB | VRAM 8GBで収まる見込み。長い文書では余裕が少ない |
| Qwen3 14B | 9.3GB | VRAM 12GBはぎりぎり、16GBなら余裕を残せる |
| Qwen3 30B(MoE) | 19GB | VRAM 24GB以上、または大容量の統合メモリ |
| Qwen3 32B | 20GB | VRAM 24GBで、短めのコンテキストなら |
※配布サイズはOllamaのモデル一覧の表示(2026年10月26日確認)です。「収まりの目安」はファイルの大きさから見た目安で、動作の保証ではありません。
注意したいのは、ファイルの大きさと必要なVRAMが同じではないことです。会話が長くなるほどコンテキスト分のメモリが増えるため、ファイルサイズに数GBの余裕を足して考えます。新しい世代のモデルでも、同じ規模ならサイズは近い値になります。たとえば9B級は5.6GB、27B級は16.8GBです(LM Studio Bionicの必要スペックの表)。VRAM別の構成と価格はAI画像生成・ローカルLLM用PC構成ガイドが詳しく扱っています。
内蔵GPUのミニPCでも動く
速さは、グラボがなくても確かめられます。GMKtecのミニPC「NucBox M7 Pro」(Ryzen 9 PRO 6950H、Radeon 680M、DDR5-4800の32GB)で、llama.cppのVulkan版(b11401)を使い、モデルの全層を内蔵GPUに載せて測った生成速度は次のとおりです。
| モデル | 形式とサイズ | 文章の生成速度 |
|---|---|---|
| Qwen3 30B-A3B | MoE・Q3_K_XL・13.8GB | 毎秒23.0トークン |
| Qwen3 14B | 通常・Q4_K_M・9.0GB | 毎秒7.2トークン |
| Qwen3 8B | 通常・Q4_K_M・5.0GB | 毎秒13.4トークン |
※128トークンの生成を3回測った平均です。入力の読み込み(512トークン)は、30B-A3Bが毎秒214トークン、8Bが毎秒197トークンでした。いずれも1件ずつ処理した値で、同時に複数の処理を流した場合の速度ではありません。
パラメータ数の大きいMoEモデルのほうが、8Bの通常のモデルより速く書き出しています。MoEは1トークンごとに動かすのがモデルの一部だけで、内蔵GPUの生成速度はメモリから読む重みの量でほぼ決まるためです。測定の条件と電力・温度はGMKtec M7 Pro実機レビューにあります。高価なグラボでなくても、使うモデルを選べば実用的な速さで動く、という点が分かります。
大きなモデルを常にメモリへ置きたい人向けで、日常の文章づくりのために必要になる機器ではありません。DGX SparkとRTX 5090の違いの比較では、32GBに収まるモデルの生成はRTX 5090のほうが速く、DGX Sparkに意味が出るのは32GBを超えるモデルを常駐させたい人です。
TrendForceは2026年9月30日の発表で、2026年第4四半期の一般DRAMの契約価格が前期比10〜15%、NAND Flashが15〜20%上がると予測しています。理由は、AIサーバー向けの需要と、メーカーが高性能なサーバー向け製品へ生産能力を優先して回していることです。契約価格と店頭価格は同じ動きとは限らないので、増設を急ぐかどうかはDDR4・DDR5メモリ価格の記事で確かめてください。
費用クラウドAPIとPC代を比べる|買い足しが得になる分かれ目は1日の処理件数
API料金とPC代を同じ条件で比べるために、2つの作業を想定します。API単価は特定のサービスの現行料金ではなく、比較のために置いた仮の値です。自分が使うモデルの公式料金表に入れ替えれば、月額=(入力トークン数×入力単価+出力トークン数×出力単価)×月の件数、で計算し直せます。
| 項目 | 仮定 |
|---|---|
| 分類 | 1件で入力1,000トークン、出力50トークン |
| 要約 | 1件で入力1,000トークン、出力500トークン |
| 件数 | 1日1,000件、30日で3万件 |
| APIの単価 100万トークンあたり | 低価格帯は入力0.2ドル・出力1ドル、中価格帯は入力1ドル・出力5ドル、高価格帯は入力5ドル・出力25ドル |
| 為替 | 1ドル150円 |
| PCの追加投資 | 12万円を24か月で割った月5,000円(すでにPCがあれば0円) |
| 電気代 | 処理中の追加消費電力150W、1kWhあたり44.67円 |
※電気代の単価は、東京電力の従量電灯Bの第3段階に再エネ賦課金を足した値で、燃料費調整は含みません。150Wは実測ではなく、比較のために置いた値です。
ローカル側の処理時間は、前の節で示した実機の速度から計算します。入力の読み込みにかかる時間と、出力の生成にかかる時間を足した値です。
| 作業 | Qwen3 30B-A3B | Qwen3 8B |
|---|---|---|
| 分類 1件あたり | 6.8秒 | 8.8秒 |
| 分類 1日1,000件 | 約1.9時間 | 約2.4時間 |
| 要約 1件あたり | 26.4秒 | 42.4秒 |
| 要約 1日1,000件 | 約7.3時間 | 約11.8時間 |
出力の短い分類なら、内蔵GPUのミニPCでも1日1,000件を2時間前後で処理できます。出力の長い要約は、MoEモデルでも1日の約3割が処理に使われる計算です。生成の速さは主にメモリの帯域で決まるので、帯域の広いグラボなら同じ作業はもっと短くなります。
| 方式 | 分類(月3万件) | 要約(月3万件) |
|---|---|---|
| APIの低価格帯 | 1,125円 | 3,150円 |
| APIの中価格帯 | 5,625円 | 15,750円 |
| APIの高価格帯 | 28,125円 | 78,750円 |
| ローカル 今のPCを使う(電気代のみ) | 約380円 | 約1,470円 |
| ローカル 12万円を追加購入(月割り+電気代) | 約5,380円 | 約6,470円 |
※上の仮定をそのまま計算した値です。キャッシュ割引、推論で増えるトークン、ツールの利用料は含みません。ローカルの電気代は、30B-A3Bで処理した場合の時間から計算しています。
低価格帯のAPIで足りる作業なら、12万円を追加して買うと月の負担はAPIの約2〜5倍になります。中価格帯では、分類はほぼ同額、要約はローカルのほうが安くなります。高価格帯のAPIを使っていた作業はローカルが大きく安くなる計算ですが、その仕事を30B級のローカルモデルが同じ品質でこなせるとは限りません。先に確かめるのは費用ではなく、ローカルのモデルで品質が足りるかどうかです。
PCの追加投資(月5,000円)がAPI料金と釣り合う1日の件数も計算しました。
| APIの単価帯 | 分類 | 要約 |
|---|---|---|
| 低価格帯 | 約4,440件 | 約1,590件 |
| 中価格帯 | 約890件 | 約320件 |
| 高価格帯 | 約180件 | 約63件 |
※月5,000円を1件あたりのAPI料金で割り、30日で割った値です。電気代は含みません。
追加購入が回収できるのは、中価格帯のAPIで要約なら1日に約320件以上、低価格帯の分類なら約4,440件以上といった規模です。AIに1日数回から数十回質問する程度の使い方では、PCを買い足してもAPI料金の節約では取り戻せません。電気代の単価の考え方はゲーミングPCの電気代の記事にあります。
この比較で分かるのは、費用の面でPCの買い足しが決め手になる人は多くない、という点です。決め手になるのは、外に出せない資料があるか、自作の処理を組み込みたいかといった、お金以外の理由のほうです。
試す手順手持ちのPCで試す手順|LM Studioは画面から、Ollamaはコマンドから
LM Studioのシステム要件では、Windowsはメモリ16GB以上、専用VRAM 4GB以上が推奨です(x64はAVX2対応が必須)。これはアプリを使い始める目安で、大きなモデルを快適に動かすための基準ではありません。
- LM Studioの公式サイトからインストールして起動します。
- モデルを探す画面(Discover)で、4B〜8B級の小さなモデルを選んでダウンロードします。
- チャット画面でモデルを読み込み、自分の作業に近い質問や文章を日本語で入れてみます。
- 手元の資料を使うなら、文書をチャットに追加して質問します。
コマンドの操作に慣れているなら、Ollamaが手軽です。モデルを取得して対話を始め、別のターミナルでモデルの置き場所を確かめます。
ollama run qwen3:8b
ollama ps
ollama psのPROCESSOR列が、モデルの載っている場所を示します。「100% GPU」はモデルがすべてGPUのメモリにあり、「100% CPU」はすべてシステムメモリにあります。「48%/52% CPU/GPU」のように両方が出るときは、一部をシステムメモリに置いています(Ollama FAQ)。両方が出ているのは、VRAMに収まっていないということです。性能を出すには、CPU側へのはみ出しを避けるのが基本です。
試すときに見るのは3点です。自分の作業で答えの質が許せるか。待ち時間が作業の流れに合うか。モデルがGPUに全部載っているか。困った点が質なのか、速さなのか、容量なのかで、次の一手が変わります。
判断グラボを買う前の判断|手持ちで試す・今のPCを使う・必要なら増設する
ollama psでの載り方の3点で困らなければ、買うものはありません。ollama psにCPUが混ざって遅さが支障になる、のいずれかを確かめられたときに考えます。使いたいモデルのファイルサイズを先に決め、それが収まるVRAMやメモリの機器を選びます。自分でモデルを動かして仕組みを学ぶことが目的なら、費用を回収する必要はありません。その場合は、予算の範囲で好きな構成を選んで問題ありません。
注意点導入前に知っておきたい4つの注意点
回答の質は、クラウドの大きなモデルより下がる場合があります。難しい推論、長い文書の整合性の確認、複数のファイルにまたがるコード修正では、差が出やすい作業です。重要な回答は人が確かめてください。
モデルの更新と入れ替えは自分で行います。クラウドAIはサービス側でモデルが更新されますが、ローカルでは新しいモデルを試すことも、使わなくなったモデルを消して容量を空けることも自分の仕事になります。
モデルごとにライセンスが違います。商用利用や再配布の条件は、配布元のモデルカードで確かめてから使ってください。
AIに与える権限が大きいほど、事故の影響も大きくなります。ファイルの削除やコマンドの実行を任せる場合は、操作できる範囲を絞り、AIの出力をそのまま実行しないでください。ネットワークに公開するなら認証も必要です。
おすすめ増設が必要と分かったときの入口になる2台
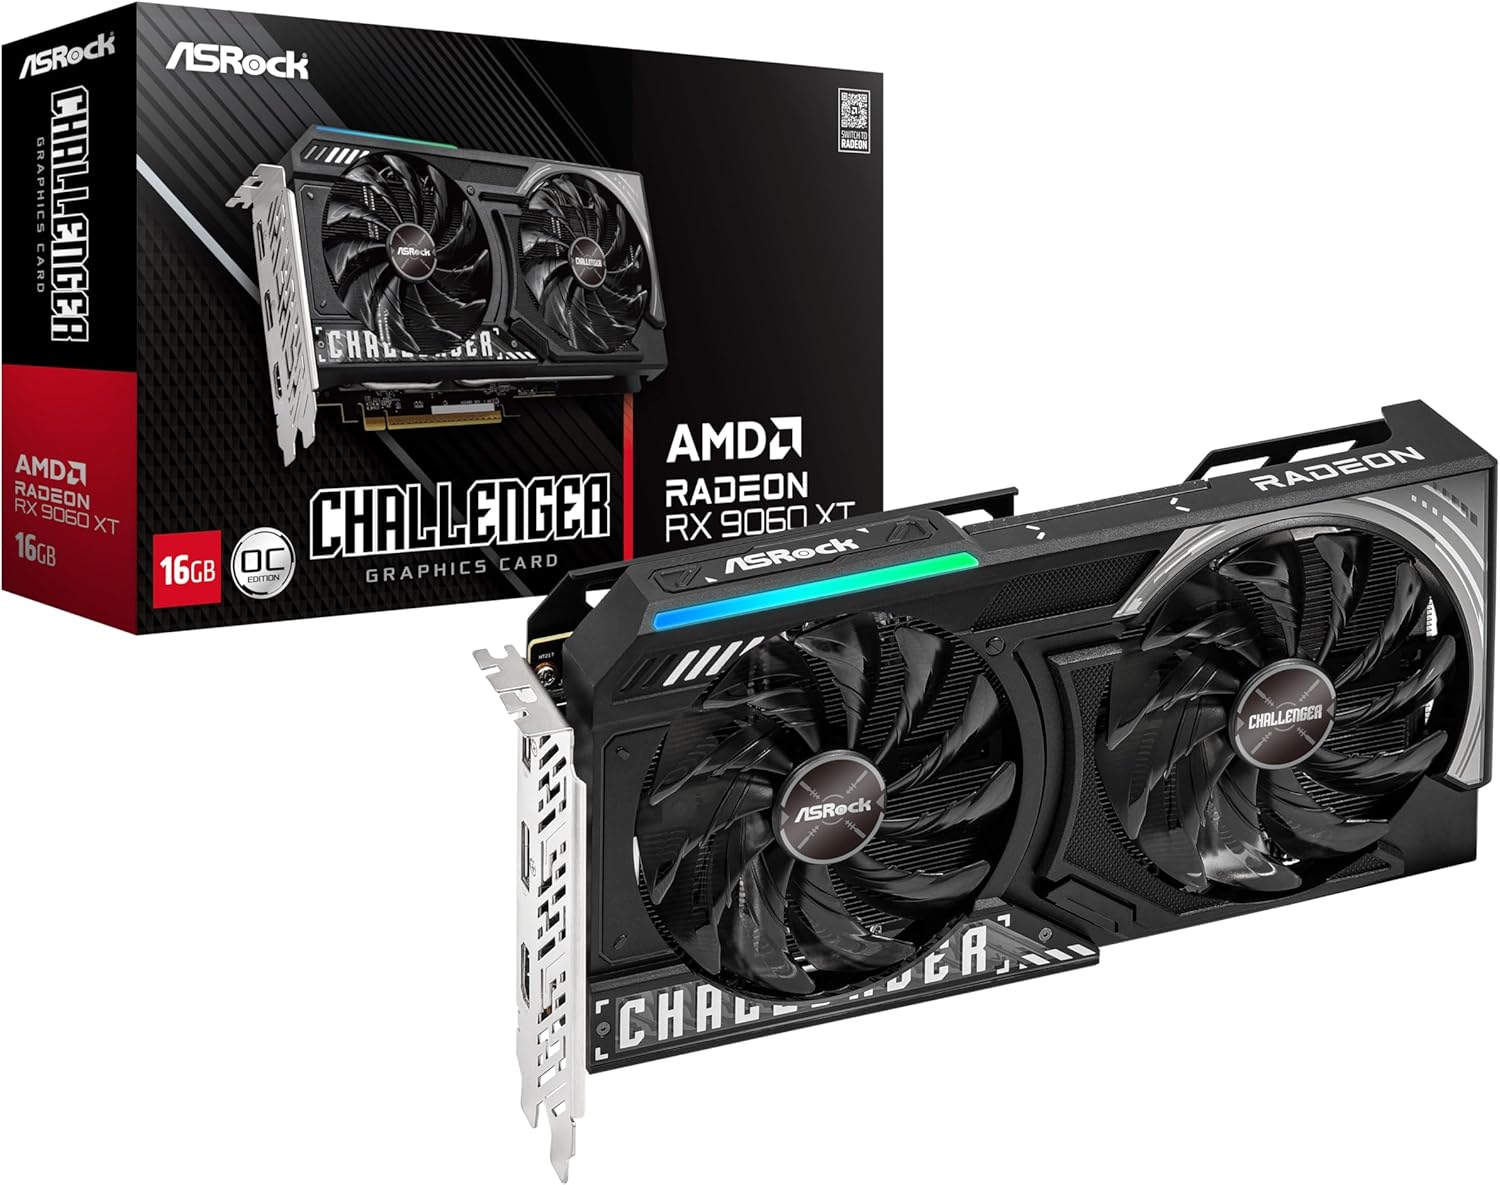
試した結果、VRAMかメモリの不足が分かった人向けに、VRAM 16GBのグラボと、32GBメモリのミニPCを挙げます。どちらも、先に使いたいモデルのファイルサイズを決めてから選んでください。

FAQよくある質問
まとめまとめ|ローカルLLMは「動かす場所を自分で決められるAI」
ローカルLLMは、ChatGPTやClaudeより賢いAIを安く使う仕組みではありません。毎日の質問や文章づくりならクラウドのAIで足り、PCを買い足してもAPI料金の節約では取り戻せない場合が多くあります。役に立つのは、外に出せない資料の処理、大量の分類・要約、自作ツールへの組み込みのように、AIを動かす場所を自分で決めたい場面です。
グラボを買う前に、手持ちのPCで小さなモデルを試してください。困った点が質なら、クラウドに回すか大きなモデルが載る機器を考えます。遅さや載らなさなら、使いたいモデルのサイズを決めてからVRAMやメモリを選びます。
ローカルLLMの価値は「高性能なAIを持つこと」ではなく、「どこで動かすかを自分で決められること」です。まず手持ちのPCで試し、足りない点が分かってから増設を決めれば、グラボ選びで失敗しにくくなります。
出典:LM Studio Offline Operation、LM Studio System Requirements、LM Studio Chat with Documents、LM Studio Developer Docs、Ollama FAQ、Ollama Context length、Ollama Qwen3 モデル一覧、OpenAI Data controls in ChatGPT、Anthropic Is my data used for model training?、TrendForce 4Q26 メモリ市場予測
あわせて読みたい


Amazonの価格・在庫情報について




Amazonの価格・在庫情報について