Luceboxが5,999ドルで直販開始|R9700+Strix Haloは「160GB VRAM」ではない【2026年9月】
本記事にはアフィリエイト広告(Amazon・楽天市場等)のリンクが含まれています。
128GB+32GBは「160GB VRAM」ではなく、容量担当と速度担当を分ける設計です
出典:Lucebox公式ストア、Lucebox公式Performanceページ、およびLucebox公式ブログ「DeepSeek V4 Asymmetric Parallelism」にもとづきます(2026年9月24日確認)。
Ryzen AI Max+ 395に128GBのLPDDR5Xメモリを搭載し、さらに32GBのGDDR6を備えたRadeon AI PRO R9700まで追加する。一見すると「128GBもの大容量共有メモリがあるのに、なぜ単体GPUを追加するのか」と疑問に感じる構成です。
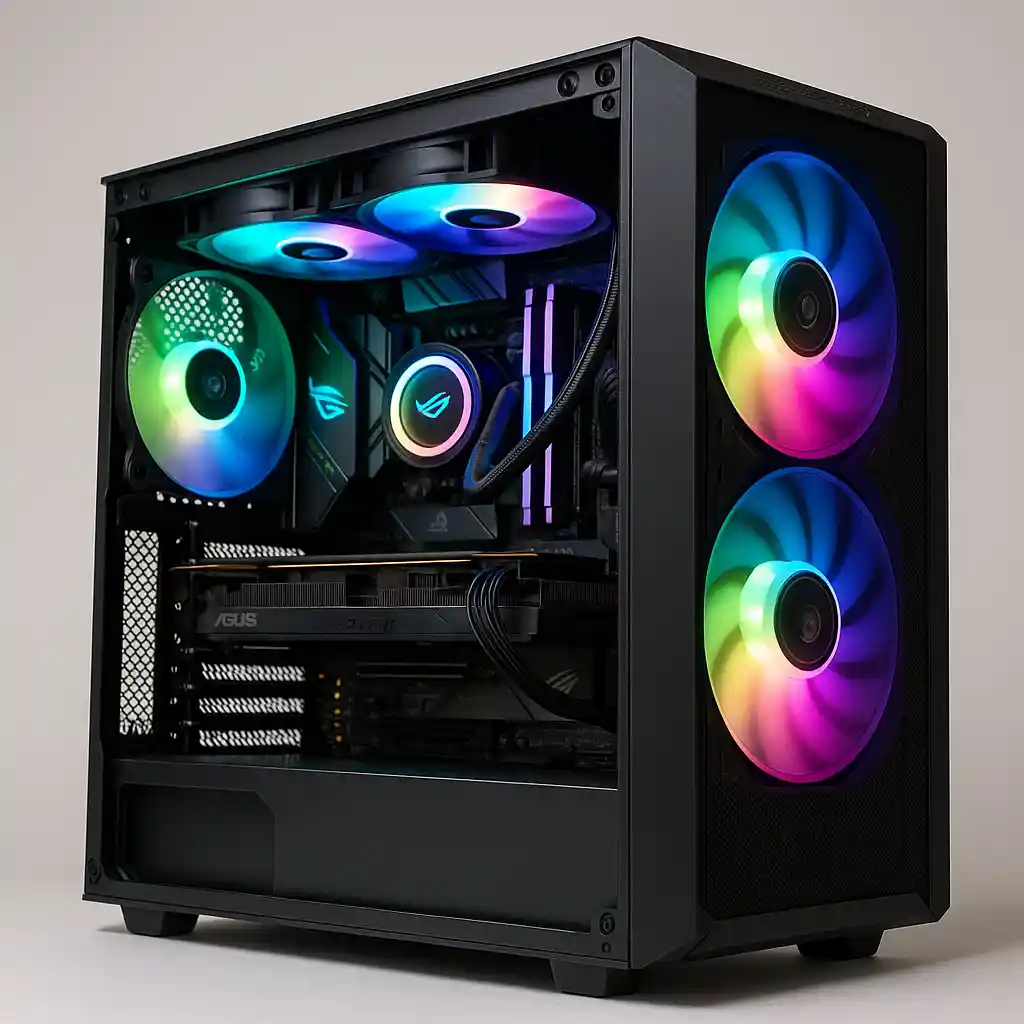
ローカルAI向けワークステーションを開発するLuceboxは、これまで購入希望者への割り当て制だった同名製品について、5,999ドルでの直接注文を開始しました。Ryzen AI Max+ 395、128GB LPDDR5X-8000、Radeon AI PRO R9700 32GB、2TB NVMe SSDなどを11.97Lの筐体へ収めたAI推論向けワークステーションです。
ただし、このPCで本当に面白いのは5,999ドルという価格ではありません。Luceboxは128GBと32GBを単純に足して「160GBのVRAM」として扱っているわけではなく、容量の大きなStrix Halo側と、帯域幅の大きなR9700側へAIモデルの処理を意図的に振り分けています。大容量共有メモリを持つAPUと高速な単体GPUを競合させるのではなく、同時に使うという発想です。
目次
概要LuceboxはRyzen AI Max+ 395とR9700を組み合わせるAIワークステーション
Luceboxの中核となるRyzen AI Max+ 395は、Zen 5の16コア32スレッドCPUと40CUのRadeon 8060Sを統合したStrix Halo世代のプロセッサです。AMD公式仕様では最大128GBのLPDDR5X-8000に対応し、メモリインターフェイスは256bit、メモリ帯域幅は最大256GB/sです。
| 項目 | 内容 |
|---|---|
| 価格 | Developer 5,999ドル/Business 7,999ドル |
| CPU/GPU | Ryzen AI Max+ 395(Zen 5 16C/32T、Radeon 8060S 40CU) |
| メモリ | 128GB LPDDR5X-8000(256bit、最大256GB/s) |
| 単体GPU | Radeon AI PRO R9700(32GB GDDR6、64CU、最大640GB/s、TBP 300W) |
| ストレージ | 2TB NVMe SSD |
| 筐体 | 11.97L(340×110×320mm)、1,000W 80 PLUS Platinum電源 |
| 出荷 | Batch 3は完売、Batch 4は2026年11月出荷予定 |
R9700はRDNA 4世代のワークステーションGPUで、64CU・32GB GDDR6・256bitメモリバスを搭載します。AMD公式仕様のピークメモリ帯域幅は640GB/sで、TBPは300Wです。ROCmの公式資料でもgfx1201としてサポートされています。
つまりLuceboxには、容量128GB・帯域幅256GB/sのStrix Halo側メモリと、容量32GB・帯域幅640GB/sのR9700側VRAMという、性格のまったく違う2つのメモリ領域があります。
誤解訂正128GB+32GBだから「160GB VRAM」になるわけではない
ここはLuceboxを理解するうえで最も重要な部分です。128GBのLPDDR5Xと32GBのGDDR6は、一枚のGPUが自由にアクセスできる160GBの巨大なVRAMではありません。Lucebox自身も、この構成を「two pools(2つのプール)」と説明しています。128GBはRyzen AI Max+ 395のCPUとRadeon 8060Sが共有するメモリで、32GBはR9700専用のGDDR6です。
Strix Halo側の帯域幅は256GB/sなのに対し、R9700は640GB/sです。R9700側は容量こそ4分の1ですが、メモリ帯域幅は約2.5倍あります。LLM推論ではモデルサイズだけでなく、推論中に重みをどれだけ速く読み出せるかも性能に大きく影響します。そのため、単純にモデル全体を128GB側へ置けばよいとは限らず、逆にR9700の32GBだけでは100GB級のモデルを丸ごと収められません。
そこでLuceboxは、「大きいが比較的遅いメモリ」と「小さいが高速なメモリ」を同時に利用します。これは一般的なゲーミングPCで「VRAMが足りなくなったのでシステムRAMへ退避する」という使い方とはかなり違います。Ryzen AI MaxのVariable Graphics Memoryのように内蔵GPU側のメモリ配分を増減させる設定とも別物で、2つの独立したGPUへ処理そのものを分担させる設計です。
役割分担R9700は高速処理、Strix Haloは大容量モデルを担当する
Luceboxが公開しているDeepSeek V4 Flashの実装を見ると、この役割分担がより分かりやすくなります。DeepSeek V4 Flashは284BパラメータのMoE(Mixture of Experts)モデルで、Luceboxが使用した圧縮版でもモデルサイズは102.3GBあります。当然ながらR9700の32GB VRAMだけには収まりません。
そこでR9700には、頻繁に利用される処理経路や選択頻度の高いExpert、推論を高速化するdraft model、ワーキングキャッシュなどを配置します。一方、Strix Halo側の128GBメモリには残りのExpertを保持します。Luceboxはこの方式を「asymmetric parallelism(非対称並列処理)」と呼んでおり、2つのGPUへ同じ処理を均等に分割するのではなく、それぞれの長所に合わせて異なる仕事を担当させています。
ここがこのPC最大の特徴です。R9700はStrix Haloの代わりではなく、Strix HaloもR9700の単なるメモリ置き場ではありません。高速なR9700がレイテンシに影響しやすい処理を担当し、容量に余裕があるStrix Haloが巨大なモデルを保持しながら必要なExpertを実行するという構成になっています。
相性MoEだから「速い32GB+大きい128GB」を生かしやすい
この方式が特にDeepSeek V4 FlashのようなMoEモデルと相性がよいのも重要です。MoEでは、モデルに存在するすべてのExpertを毎回同時に計算するわけではありません。入力されたトークンに応じて必要なExpertが選択されます。そのため、頻繁に使われる処理を高速なR9700へ寄せ、それ以外を大容量のStrix Halo側へ保持するという分け方が成立します。巨大モデル全体を毎回2つのメモリ間で移動させているわけではありません。
これまでは「大容量共有メモリのAPUを買うか、高速な単体GPUを買うか」という二者択一で考えがちでした。Luceboxはその2つを組み合わせています。
性能数値51.1 tok/sという数字は最新値ではない
今回の直接販売開始を報じた海外メディアでは、DeepSeek V4 Flashを使ったLuceboxの性能として51.1 tok/sが紹介されています。これは2026年7月に公開されたベンチマークにもとづく数字です。当時のテストでは、約2Kトークンのプロンプトから128トークンを生成する条件で、ウォームアップ後3回の中央値が51.1 tok/s、1台のDGX Sparkで測定した14.09 tok/sに対して3.63倍という結果でした。
ただし、2026年9月24日時点でLuceboxのPerformanceページを確認すると、R9700+Strix HaloによるDeepSeek V4 Flashの値はさらに更新されています。現在掲載されている値は、decodeが86 tok/s、2Kでのprefillが788 tok/sです。したがって、「Luceboxの性能は51.1 tok/s」と固定して紹介すると、すでに情報が古くなっています。
Lucebox自身も、7月に公表した3.63倍という結果について「Prompts, context lengths, software, compression, and routing settings differ, so the public runs provide context rather than a controlled A/B comparison(プロンプト・コンテキスト長・ソフトウェア・圧縮方式・ルーティング設定が異なるため、公開された実行結果は統制されたA/B比較ではなく参考値である)」と明記しています。LuceboxではROCmFPXで圧縮したDeepSeek V4 Flashとdraft modelを使い、speculative decodingで高速化しているのに対し、DGX Spark側は異なる量子化方式・異なるソフトウェアスタックで測定されています。3.63倍という差は、R9700のGPU性能がDGX SparkのGB10の3.63倍という意味ではなく、モデル圧縮・配置方法・推論エンジンの最適化まで含めた「Luceboxというシステム全体」で得られた数字です。
さらに言うと、Luceboxが優位なのはdecode(生成)速度だけです。同じPerformanceページに掲載されているprefill(プロンプト処理)速度では、DGX Sparkが2Kで1,076.8 tok/sと、Luceboxの788 tok/sを上回っています。「LuceboxはDGX Sparkより全面的に速い」と単純化するのも正確ではありません。むしろ注目すべきなのは、32GBの単体GPUだけでは読み込めない100GB級モデルを、異なる2種類のGPUとメモリへ分散しながら実用的な速度で動かしている点です。
設計思想DGX Sparkとはかなり違うアプローチ
NVIDIA DGX Sparkも128GBのLPDDR5Xユニファイドメモリを搭載するローカルAI向けシステムです。GB10 Grace Blackwell Superchipを採用し、128GBのcoherent unified memory、273GB/sのメモリ帯域幅、最大1PFLOPのFP4 Tensor性能を備えています。CPUは20コアArmです。
メモリ容量だけを見ると、Strix Haloと似ています。しかしDGX SparkはCPUとGPUが共有する128GBのメモリを中心にした一体型設計です。対するLuceboxは128GBのStrix Haloに、さらに32GB・640GB/sのR9700を追加しています。つまりLuceboxが狙っているのは「巨大な一つの共有メモリ」ではなく、「容量担当と速度担当を組み合わせること」です。
筐体サイズにも大きな差があります。DGX Sparkは150×150×50.5mmで、単純計算すると体積は約1.14Lです。電源は240Wで、GB10自体のTDPは140Wとなっています。Luceboxは340×110×320mm・11.97Lで、公式値ではAI推論時のシステム消費電力が約500Wです。容積だけならLuceboxはDGX Sparkの約10倍あります。そのためLuceboxは「DGX Sparkより少し大きいミニPC」というより、GPUを1枚搭載したコンパクトワークステーションと考えるほうが実態に近いでしょう。
背景ROCm対応が進んだから成立しやすくなった構成
この構成が2026年になって現実的になった背景には、AMDのROCm対応拡大もあります。AMDのROCm 7.2系では、Ryzen AI Max+ 395のRadeon 8060Sに相当するgfx1151と、Radeon AI PRO R9700のgfx1201がいずれもサポートされています。LuceboxはUbuntu ServerとROCmを採用し、独自のHIPカーネルをR9700とStrix Haloそれぞれに最適化しています。
これはWindows搭載の一般的なゲーミングPCとは大きく違う点です。WindowsでもRyzen AI Max+ 395とR9700はPyTorch経由でROCm対応が進んでいますが、AMD自身がWindowsについては「ROCmスタック全体がまだサポートされているわけではない」と説明しています。そのため、現時点でAI推論専用機として最大限最適化するならUbuntu Serverを採用する理由があります。
用途普通のゲーミングPCとして買う製品ではない
R9700はRDNA 4 GPUなので、ハードウェアだけを見ればゲームを描画できる能力があります。しかしLucebox自体はUbuntu Serverを搭載したヘッドレス運用前提のAIワークステーションです。モニターをつないでWindowsゲームをプレイする製品として設計されているわけではありません。
LuceboxはOpenAI互換・Anthropic互換APIを用意し、Claude Code、Codex、OpenCodeなどからネットワーク越しに利用することを想定しています。初期設定後はSSHやWeb管理画面から操作でき、モデルを読み込んだ後は完全オフラインでも動作するとしています。つまり5,999ドルをゲーム性能で評価する製品ではありません。大量のコードや社内文書を外部APIへ送りたくない開発者、大規模モデルを常時ローカルで動かしたいユーザーなどが中心になります。
価格の中身5,999ドルにはハードウェア以外の価格も含まれる
Developerモデルの価格は5,999ドル、企業向けBusinessモデルは7,999ドルです。構成はRyzen AI Max+ 395、128GB LPDDR5X-8000、R9700 32GB、2TB NVMe SSD、1,000W 80 PLUS Platinum電源などで、Lucebox Engineや調整済みモデルもプリインストールされています。さらに各個体を72時間テストしてから出荷し、世界向け送料も価格に含まれます。保証は部品・作業とも1年間です。
DIY PCと比較するときには、単純なCPU+GPU+SSDの合計価格だけでは判断できません。Luceboxが販売しているのは、独自筐体だけでなく、R9700とStrix Haloを1つのモデルで同時に使うためのソフトウェアまで組み合わせた完成環境だからです。Batch 3はすでに完売しており、現在受け付けているBatch 4は2026年11月出荷予定です。
現実的な選択肢5,999ドルが難しい場合はどうすればいいか
5,999ドルという価格は、一般的なPC購入の感覚からすればかなり高額です。今すぐLuceboxを買う予定がなくても、この構成が示す考え方は今すぐ役立つ場面があります。
これから128GB以上の共有メモリを備えたAPUが増えていけば、「大容量APUだけでAIを動かす」のではなく、「APUへ巨大モデルを保持し、単体GPUに高速処理を任せる」という構成も増えていく可能性があります。Ryzen AI Max搭載ミニPCの選び方を検討する際も、単体GPUとの組み合わせ余地があるかどうかは今後のチェックポイントになりそうです。
代替案日本で今すぐ買えるRyzen AI Max機と比べると
Luceboxは海外直販のみで、国内から通常のオンラインショップ感覚で買える製品ではありません。同じRyzen AI Max+ 395を積みながら、国内のAmazonで購入できるミニPCと並べると、Luceboxの立ち位置がより具体的になります。
| 製品 | メモリ構成 | 価格帯 |
|---|---|---|
| Lucebox | 128GB共有+R9700 32GB GDDR6(640GB/s) | 5,999ドル〜(海外直販のみ) |
| GMKtec EVO-X3 | 128GB共有のみ(背面OCuLinkで外付けGPU拡張可) | 60万円台(Amazon.co.jp) |
| MINISFORUM MS-S1 MAX | 128GB共有のみ(単体GPUなし) | 65万円台(Amazon.co.jp) |
GMKtec EVO-X3とMINISFORUM MS-S1 MAXは、どちらもStrix Halo側の128GB共有メモリはLuceboxと同じですが、R9700のような高速・専用のVRAMプールを持ちません。EVO-X3は背面にOCuLinkを備えるため、外付けGPUを足せば構成としてはLuceboxに近づけられますが、asymmetric parallelismのような推論エンジン側の最適化は含まれておらず、自分で構築する前提になります。

FAQよくある質問
まとめまとめ|重要なのは「APUかGPUか」ではない
これまでPCのAI性能を考える場合、「大容量メモリを使えるAPU」と「高速な専用VRAMを持つGPU」は競合する選択肢として扱われることが多くありました。Luceboxはその考え方を変える一例です。
Ryzen AI Max+ 395は128GBという容量を担当し、Radeon AI PRO R9700は32GB・640GB/sという速度を担当します。さらにソフトウェア側が、どの処理をどちらへ置くかまで制御します。その結果、R9700だけには収まらない284BパラメータのDeepSeek V4 Flashを、1台のワークステーション内で両GPUにまたがって動かしています。
今回紹介された51.1 tok/sという数字も、それが2026年7月時点のものであり、現在のLucebox Engineは86 tok/sまで結果を伸ばしていること、DGX Sparkとの3.63倍という比較も単純なGPU性能差ではなくシステム全体の数字であることを踏まえて読む必要があります。5,999ドルという価格から一般ユーザー向けとは言いにくい製品ですが、大容量共有メモリのAPUは単体GPUを不要にするだけの技術ではなく、単体GPUと組み合わせることで別の使い方ができることを示した一台です。
Luceboxの128GB+32GBは「160GBのVRAM」ではなく、容量担当のStrix Haloと速度担当のR9700という2つの独立したメモリプールです。51.1 tok/s・DGX Sparkの3.63倍という数字は2026年7月時点のもので、現在は86 tok/sまで更新されており、3.63倍という比較もシステム全体の数字である点に注意してください。
5,999ドルが出せない場合も、OCuLink搭載のRyzen AI Maxミニ PCへ単体GPUを追加する、あるいはDGX Sparkとの用途の違いで選ぶといった選択肢があります。
あわせて読みたい